ALTK-Evolve podľa IBM Research: textové pravidlá z trajektórií bez úprav váh, s vyšším Pass^4 aj vyššou cenou vstupných tokenov
IBM Research opisuje ALTK-Evolve ako spôsob, ako z minulých behov agenta vyťažiť krátke textové pravidlá a pripojiť ich do systémového promptu. V dodanom článku autori tvrdia, že takto v τ²-bench zlepšili výsledky bez dolaďovania váh modelu, no prínos sa líši podľa domény a väčší blok pravidiel zvyšuje cenu najmä cez vstupné tokeny.
ALTK-Evolve stavia na naučených pravidlách v prompte, nie na tréningu váh
IBM Research v dodanom texte opisuje ALTK-Evolve ako postup, pri ktorom sa z predchádzajúcich trajektórií agenta vyťažia krátke behaviorálne pravidlá a tie sa potom pridajú do systémového promptu pri ďalších rozhovoroch. Dôležité je, že podľa autorov nejde o úpravu váh modelu ani o ručné anotovanie: ten istý model má slúžiť na extrakciu pravidiel aj na samotné vybavovanie úloh. V testoch na τ²-bench autori zároveň píšu, že samotný benchmarkový scaffold ReAct nemenili; zásah mal spočívať len v pridaní bloku naučených odporúčaní za doménovú politiku.
Ako sa pravidlá učia z trajektórií
Mechanizmus je v článku popísaný pomerne priamo. Model analyzuje pokusy agenta na trénovacích úlohách a zo zlyhaní aj úspechov destiluje krátke textové pravidlá, napríklad k autentifikácii zákazníka, potvrdeniu transakcie alebo spracovaniu vrátenia. Tieto pravidlá sa následne bez zmeny aplikujú na oddelený held-out test set. To je podstatný rozdiel oproti fine-tuningu: pamäť sa tu prejavuje ako doplnený text v prompte, nie ako preučený model.
Mean Accuracy verzus Pass^4: schopnosť proti spoľahlivosti
Autori rozlišujú dve metriky. Mean Accuracy je priemerná úspešnosť cez štyri pokusy na úlohu, teda skôr miera schopnosti, ako často agent trafí správne riešenie. Pass^4 je prísnejšia metrika: započíta len tie úlohy, ktoré prejdú vo všetkých štyroch nezávislých pokusoch, a v článku je výslovne označená ako os spoľahlivosti. Prakticky to znamená, že rozdiel medzi priemernou presnosťou a Pass^4 ukazuje, či agent uspeje iba často, alebo aj konzistentne.
Presne doložené výsledky s GPT-4.1 na held-out testoch
Na held-out testoch s GPT-4.1 uvádza článok pre retail baseline Mean Accuracy 78,1 % a Pass^4 57,5 %. Varianta lossless sa má posunúť na 82,5 % a 67,5 %, teda o +4,4 percentuálneho bodu v Mean Accuracy a +10 bodov v Pass^4. V airline je obraz menej priamočiary: baseline má 57,5 % a 35,0 %, konfigurácia sup3 60,0 % a 45,0 %, zatiaľ čo lossless vedie v Mean Accuracy na 65,0 %, ale v Pass^4 klesá na 40,0 % oproti 45,0 % pri sup3. Práve tu je vidieť rozdiel medzi priemernou výkonnosťou a spoľahlivosťou najzreteľnejšie.
Koľko pravidiel sa oplatí, závisí od domény
Dodané dôkazy nepodporujú univerzálnu tézu, že viac naučených pravidiel je vždy lepšie. V retaili autori píšu, že viac usmernení pomáha na každej sledovanej metrike a výraznejší skok prichádza až pri plnej lossless sade. V airline sa však výsledok láme: lossless má vyššiu priemernú presnosť, no kompaktnejšie jadro sup3 dosahuje lepší Pass^4. Z textu preto vyplýva skôr to, že počet pravidiel treba ladiť podľa domény, nie zafixovať na jednu hodnotu.
Vyššia cena vstupných tokenov a opatrnosť pri leaderboarde
Článok otvorene priznáva, že pravidlá nie sú zadarmo. Uvádza, že náklad rastie najmä cez prompt input tokens, nie cez dlhšie konverzácie. Pri retaile má cena za konverzáciu podľa tabuľky stúpnuť z 0,084 dolára pri baseline na 0,139 dolára pri lossless, teda o 65 %. V airline ide z 0,081 na 0,107 dolára, čo je nárast o 32 %. To znamená, že z dodaných podkladov nemožno tvrdiť lacnejšie volania; skôr naopak, vstupné tokeny zdražujú beh agenta.
Autori zároveň rozlišujú medzi held-out testom a leaderboardovým base splitom. Výslovne píšu, že submission sa hodnotí na full base split (train ∪ test), a preto sa tieto čísla líšia od test-task výsledkov vyššie. Prvenstvo teda treba pripísať autorom a konkrétnemu snapshotu leaderboardu z 12. októbra 2026, nie všeobecne celému benchmarku. V texte sa uvádza, že retailové riešenie s learned guidelines dosiahlo na base split Pass^4 = 67,5 % a v snapshot-e bolo prvé; pri airline sa pre gpt-4.1 uvádza 44 % a 8. miesto, kým s gpt-5.5 autori tvrdia 82,0 % a prvé miesto. Keďže ide o tvrdenia z prvej strany v komunitnom článku, bez našich nezávislých testov ich treba čítať ako autorom reportované výsledky.
Zdroje
Súvisiace
Ďalšie články k téme
ML Intern ukazuje, čo má agent odovzdať po tréningu: model aj poctivé porovnanie
Praktické príklady Hugging Face spájajú rozpočet, skúšobný beh a meranie zlepšenia. Samotné dokončenie tréningu nestačí.
Benchmark AutoBench tvrdí, že testované LLM routery často neprekonajú ani jednoduchú statickú voľbu modelu
AutoBench Router Benchmark hodnotí routery tak, že iba sleduje, ktorý model zvolia, a k tejto voľbe priradí už uložené skóre aj cenu. Podľa autorov pritom žiadny z testovaných routerov neprekonal statickú voľbu Always-Luna súčasne v kvalite aj cene a viaceré nastavenia sa správajú takmer ako konštantná politika jedného modelu.
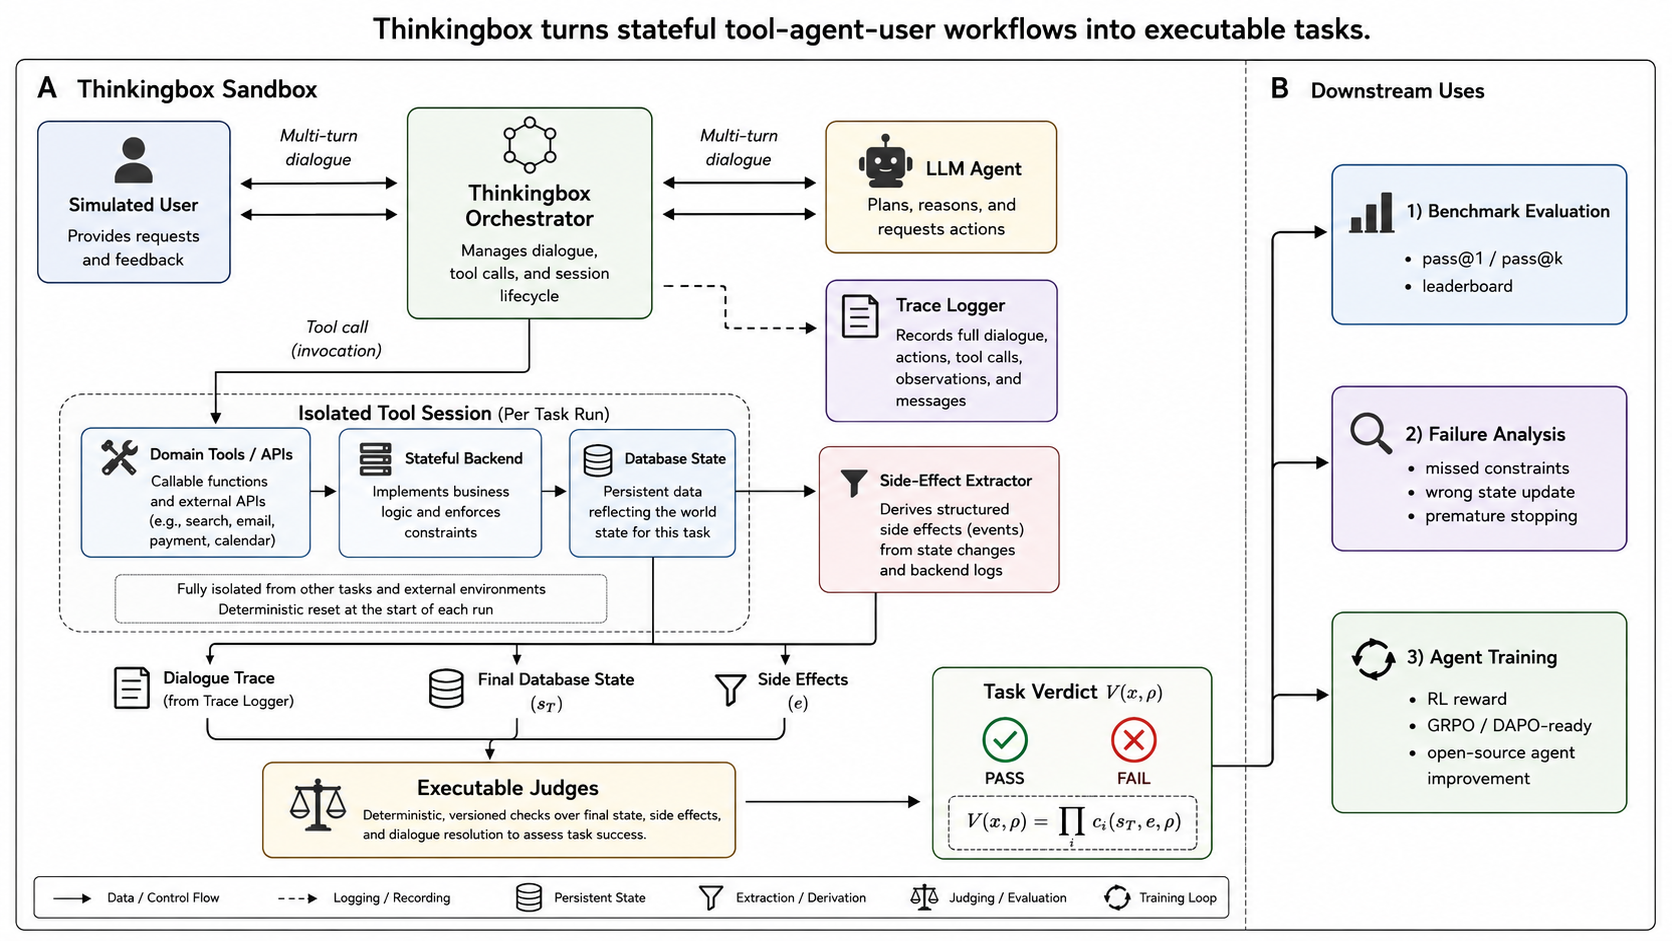
ThinkingBox kontroluje, čo agent naozaj zmenil v databáze
Microsoft a spoluautori testujú 507 pracovných postupov opakovane. Presvedčivá odpoveď ani úspešné volanie nástroja ešte neznamenajú správny výsledok.
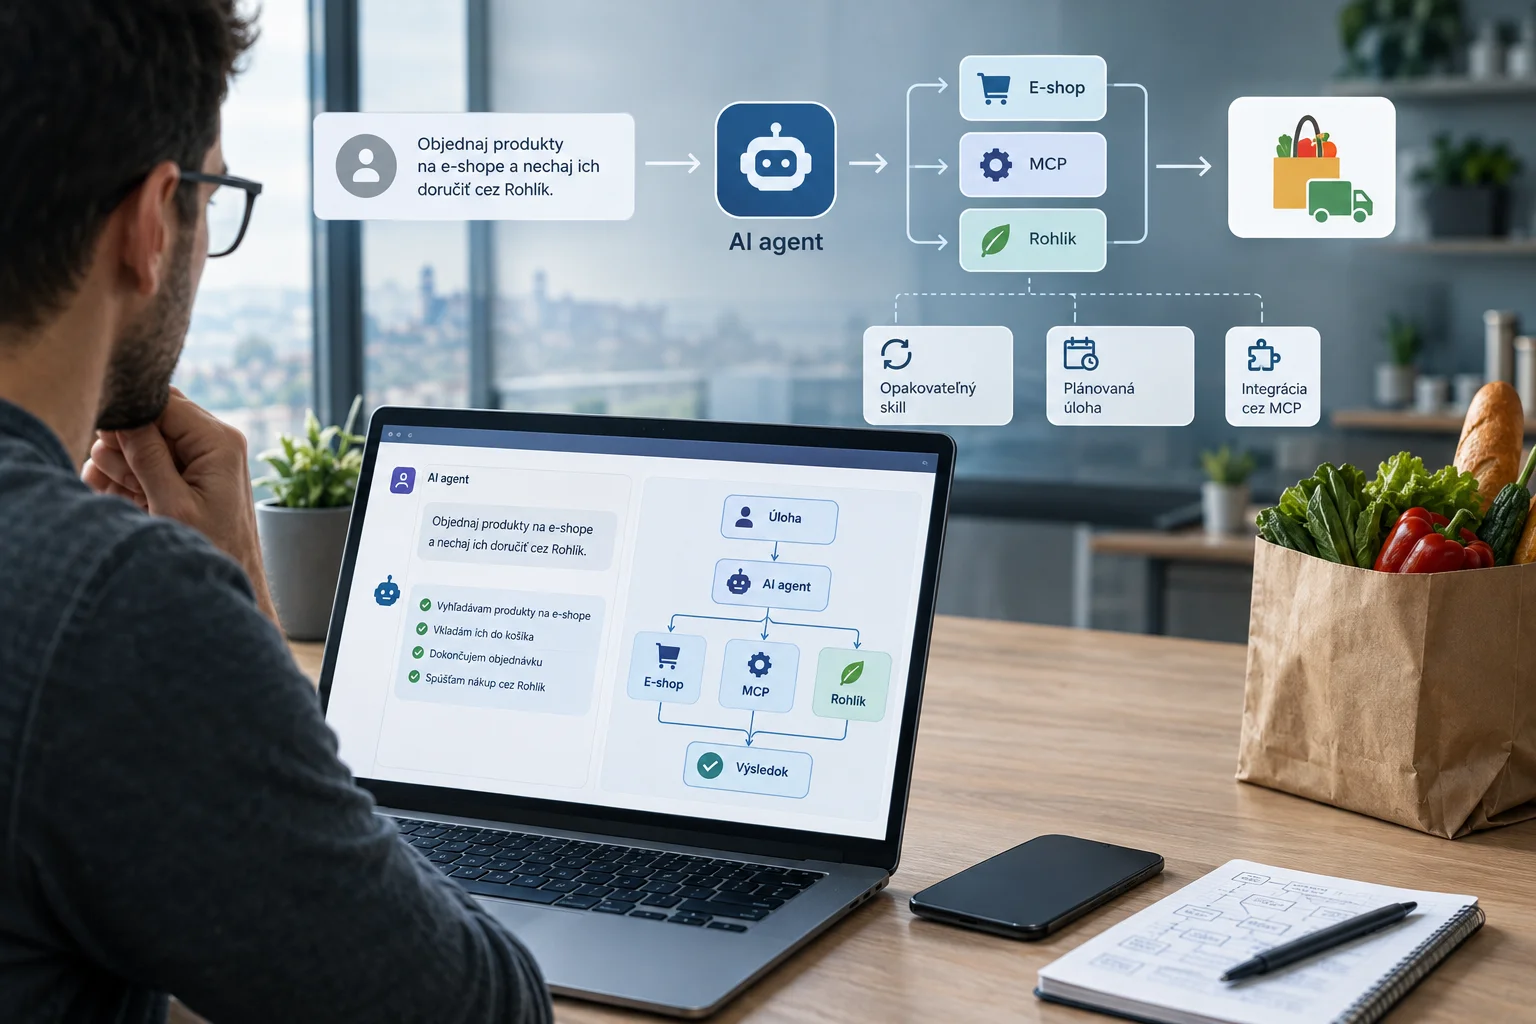
Jirka Herník v opise videa ukazuje workflow AI agenta pre e-shop a MCP nákup cez Rohlík
Oficiálny opis videa z kanála Jirku Herníka popisuje praktický postup, v ktorom AI agent dostane konkrétnu úlohu pre e-shop, následne sa z workflow stane opakovateľný skill, plánovaná úloha alebo integrácia cez MCP. Podklad je použiteľný ako kvalitatívny rozbor princípu, nie ako nezávisle overený benchmark schopností nástrojov.