UltraBERT spája triedenie textov a vyhľadávanie v malom modeli
DMIS Lab vydal anglické encodery s kontextom 32-tisíc tokenov. Tréning mieša dve odlišné úrovne zakrývania slov.
Nie každá textová úloha potrebuje generovať odpoveď
UltraBERT od DMIS Lab je rodina encoderov vo veľkostiach 150 a 380 miliónov parametrov. Namiesto postupného vytvárania slov spracuje vstup a pripraví reprezentáciu vhodnú na klasifikáciu alebo vyhľadávanie. Samostatný variant UltraBERT-Embed-150M poskytuje pripravené embeddingy. Váhy sú vydané pod licenciou Apache 2.0.
Takýto model môže triediť prichádzajúce požiadavky alebo pripravovať index dokumentov. Pri dobre ohraničenej úlohe nemusí veľký konverzačný model priniesť primeranú výhodu k svojim nákladom. Rodina je však zameraná na angličtinu; kvalitu slovenského archívu nemožno odvodiť z anglického benchmarku.
Dve tréningové úlohy namiesto jedného kompromisu
Autori skúmali, aký podiel tokenov má byť počas učenia zakrytý. Nižší podiel podľa ich experimentov prospieval klasifikácii, vyšší vyhľadávaniu. UltraBERT preto mieša príklady s päťpercentným a päťdesiatpercentným zakrytím a používa pre ne samostatné výstupné hlavy pri tréningu.
Modelová karta rozlišuje základný checkpoint od modelu pripraveného na konkrétnu úlohu. Pri klasifikácii treba doplniť a doladiť príslušnú hlavu; pri vyhľadávaní možno siahnuť po embeddingovom variante. Označenie jednej rodiny teda neznamená, že všetky checkpointy majú rovnaké vstupy, výstupy a odporúčaný spôsob použitia.
Vo vyhľadávacom systéme sa dokumenty prevedú na vektory vopred a pri otázke sa hľadajú podobné reprezentácie. Konverzačný model potom môže pracovať iba s vybranými úsekmi. Kvalita malého encodera tak ovplyvní aj následnú veľkú odpoveď: ak relevantný podklad vôbec nenájde, ďalší model ho nemá z čoho správne citovať.
Dlhý kontext treba vyhodnotiť na vlastnom archíve
Podporovaný kontext dosahuje 32-tisíc tokenov. To môže pomôcť pri dlhších dokumentoch, ale voľba medzi celým dokumentom a kratšími úsekmi závisí od hľadanej informácie. Veľký blok môže spájať viac tém a sťažiť presné vrátenie relevantného odseku.
Praktický test má preto porovnať úspešnosť nájdenia odpovede, rýchlosť indexovania a veľkosť uložených vektorov. Pri triedení je dôležitá kvalita označených príkladov a omyly medzi podobnými kategóriami. Výsledky autorov ukazujú, že úprava tréningového postupu môže byť užitočnejšia než ďalšie predlžovanie učenia. Pre podnik je podstatný výsledok na vlastných dokumentoch, nie samotná veľkosť modelu alebo prvenstvo v jednej tabuľke.
Technický kontext
Stav overenia: Spracované podľa zdroja; redakcia postup nereprodukovala.
Verzie: Zdroj neuvádza konkrétne verzie.
Podmienky použitia: Použitie závisí od konkrétnej konfigurácie a dokumentácie uvedenej v zdrojoch.
Obmedzenia: Redakcia nereprodukovala testy dodávateľov; staršie udalosti sú v texte datované.
Zdroje
Súvisiace
Ďalšie články k téme
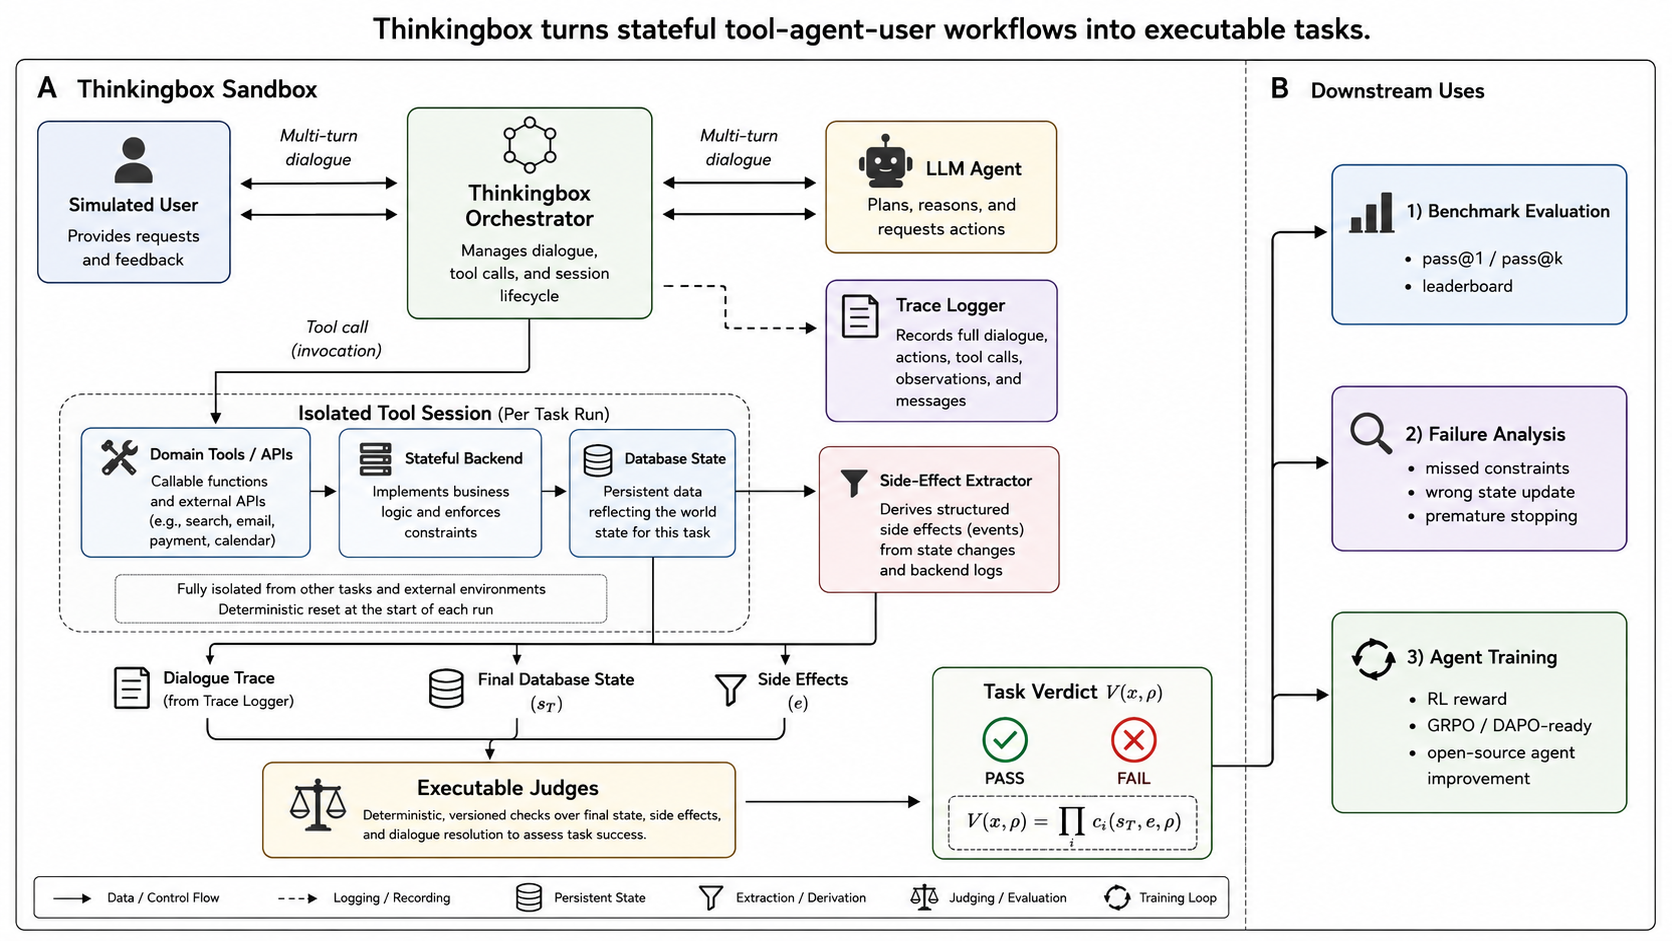
ThinkingBox kontroluje, čo agent naozaj zmenil v databáze
Microsoft a spoluautori testujú 507 pracovných postupov opakovane. Presvedčivá odpoveď ani úspešné volanie nástroja ešte neznamenajú správny výsledok.
ML Intern ukazuje, čo má agent odovzdať po tréningu: model aj poctivé porovnanie
Praktické príklady Hugging Face spájajú rozpočet, skúšobný beh a meranie zlepšenia. Samotné dokončenie tréningu nestačí.
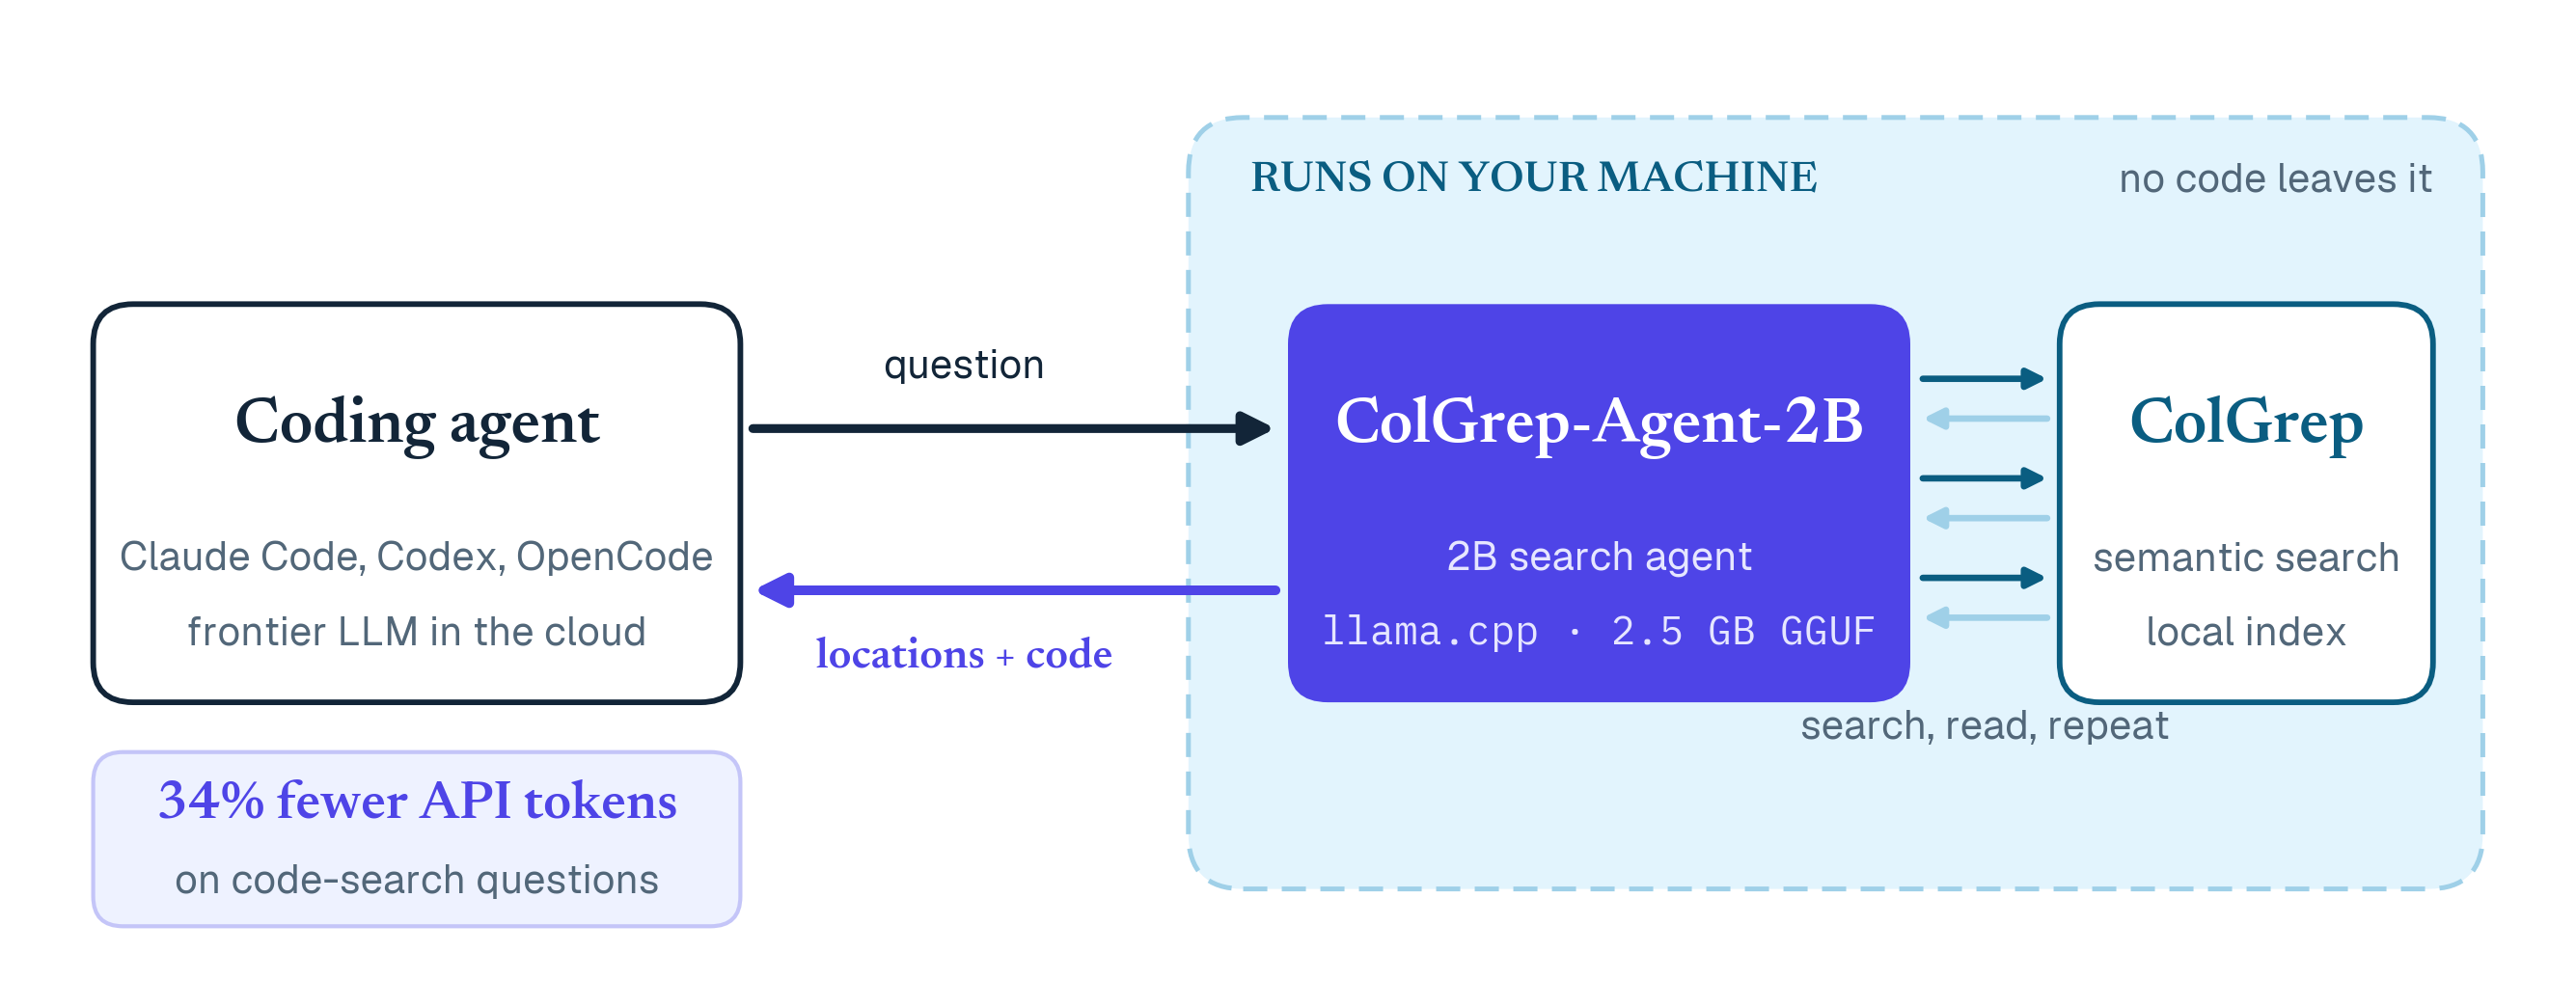
Malý ColGrep-Agent hľadá kód za veľký model. Úspora tokenov má časovú cenu
LightOn ukazuje dvojmiliardový model na orientáciu v repozitári. Výsledky oddeľujú nájdenie súborov od samotnej opravy programu.
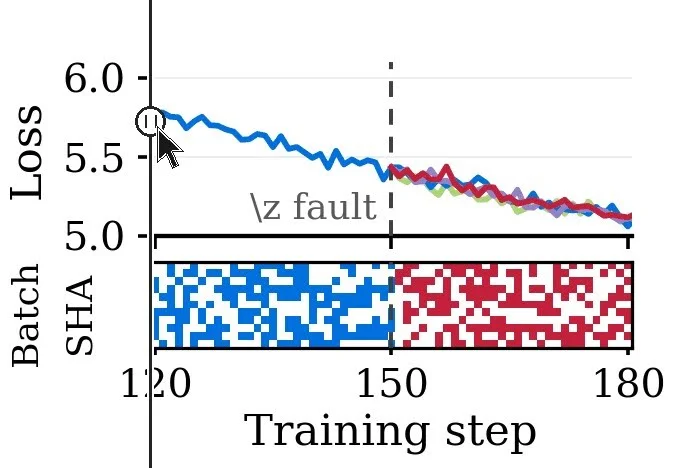
Zephon udrží poradie tréningových dát aj po zmene počtu GPU
Dátový loader pre TorchTitan rieši skrytý problém experimentov: iné rozdelenie výpočtu môže modelu predložiť iné dáta.