KInIT s analytikmi ministerstva školstva riešil dokumenty, embeddingy a lokálne modely
Spolupráca sa sústredila na konkrétne pracovné úlohy Inštitútu vzdelávacej politiky. Konzultácie ešte nie sú dôkazom hotového produkčného systému.
Technický tím nepotreboval iba úvod do AI
KInIT 12. októbra zverejnil opis spolupráce s Ministerstvom školstva, výskumu, vývoja a mládeže SR. Najtechnickejšia časť sa týkala Inštitútu vzdelávacej politiky, ktorého analytici už pracovali s programovaním, jazykovými modelmi a strojovým učením. Program preto nadviazal na ich konkrétne problémy, nie iba na všeobecné predstavenie chatbotov.
Inštitút pripravuje analýzy a podklady pre vzdelávaciu politiku. Pracuje pritom s rozsiahlymi dokumentmi aj národnými a medzinárodnými dátami. To vysvetľuje, prečo sa spolupráca sústredila na spracovanie textu, predikčné metódy a zmysluplné využitie modelov pri analytickej práci.
Ako zoskupiť tisíce textových odpovedí
Jednou z konzultovaných úloh bolo spracovanie veľkého množstva textu z dotazníkov. KInIT opisuje návrh zoskupovania vetných embeddingov pomocou k-means. Text sa najprv prevedie na číselnú reprezentáciu významu a podobné odpovede sa následne rozdelia do skupín, ktoré môže analytik ďalej preskúmať.
Predmetom diskusie boli aj RAG, teda vyhľadanie relevantných podkladov pred tvorbou odpovede, a lokálne nástroje pre citlivé dokumenty. Tieto prístupy riešia rozdielne problémy: zoskupovanie pomáha orientovať sa v množstve odpovedí, zatiaľ čo RAG poskytuje modelu konkrétny dokumentový kontext.
Čo bolo skutočne výsledkom spolupráce
Zdroj opisuje školenia, návrhy postupov a individuálne konzultácie. Neuvádza meranie presnosti hotového klasifikátora ani úsporu času produkčnej aplikácie. Preto by bolo nepresné tvrdiť, že ministerstvo už nasadilo automatický systém na rozhodovanie o školstve.
Praktická hodnota prípadu je v spôsobe zadania: technicky pokročilý tím priniesol vlastné dáta a pracovné otázky. Pri ďalšom overovaní by bolo vhodné porovnať vytvorené skupiny s hodnotením analytikov, sledovať zle zaradené odpovede a kontrolovať reprezentatívnosť výsledkov. Lokálne spracovanie zase potrebuje vlastné nastavenie prístupov a prevádzky. Prípad ukazuje, ako sa všeobecné vzdelávanie dá premeniť na konkrétny návrh práce s dokumentmi bez predstierania výsledkov, ktoré zatiaľ neboli zverejnené.
Pri dotazníkoch navyše podobnosť viet nemusí znamenať rovnaký názor. Dve odpovede môžu používať rovnaké slová, ale líšiť sa negáciou alebo podmienkou. Pracovný postup preto potrebuje ľudské overenie vzoriek z jednotlivých skupín a kontrolu menšinových tém. Práve takéto otázky premieňajú všeobecné školenie embeddingov na analytickú úlohu s jasným kritériom kvality, ktorú možno porovnať s doterajším ručným spracovaním.
Technický kontext
Stav overenia: Spracované podľa zdroja; redakcia postup nereprodukovala.
Verzie: Zdroj neuvádza konkrétne verzie.
Podmienky použitia: Použitie závisí od konkrétnej konfigurácie a dokumentácie uvedenej v zdrojoch.
Obmedzenia: Redakcia nereprodukovala testy dodávateľov; staršie udalosti sú v texte datované.
Zdroje
Súvisiace
Ďalšie články k téme
KInIT a SFÉRA modelujú mikrosiete: kedy energiu spotrebovať a kedy uložiť
Slovenský výskumný projekt skúma tok energie medzi spotrebiteľmi, obnoviteľnými zdrojmi a batériami. Verejný opis zatiaľ neuvádza úsporu konkrétnej prevádzky.
MicroStep-MIS prepája meteorologickú AI s pravidlami jej používania
KInIT opisuje spoluprácu s MicroStep-MIS na zodpovednom používaní AI. Popri meteorologických modeloch sa venovala aj dokumentačnému chatbotu, interným pravidlám a pripravenosti firmy.
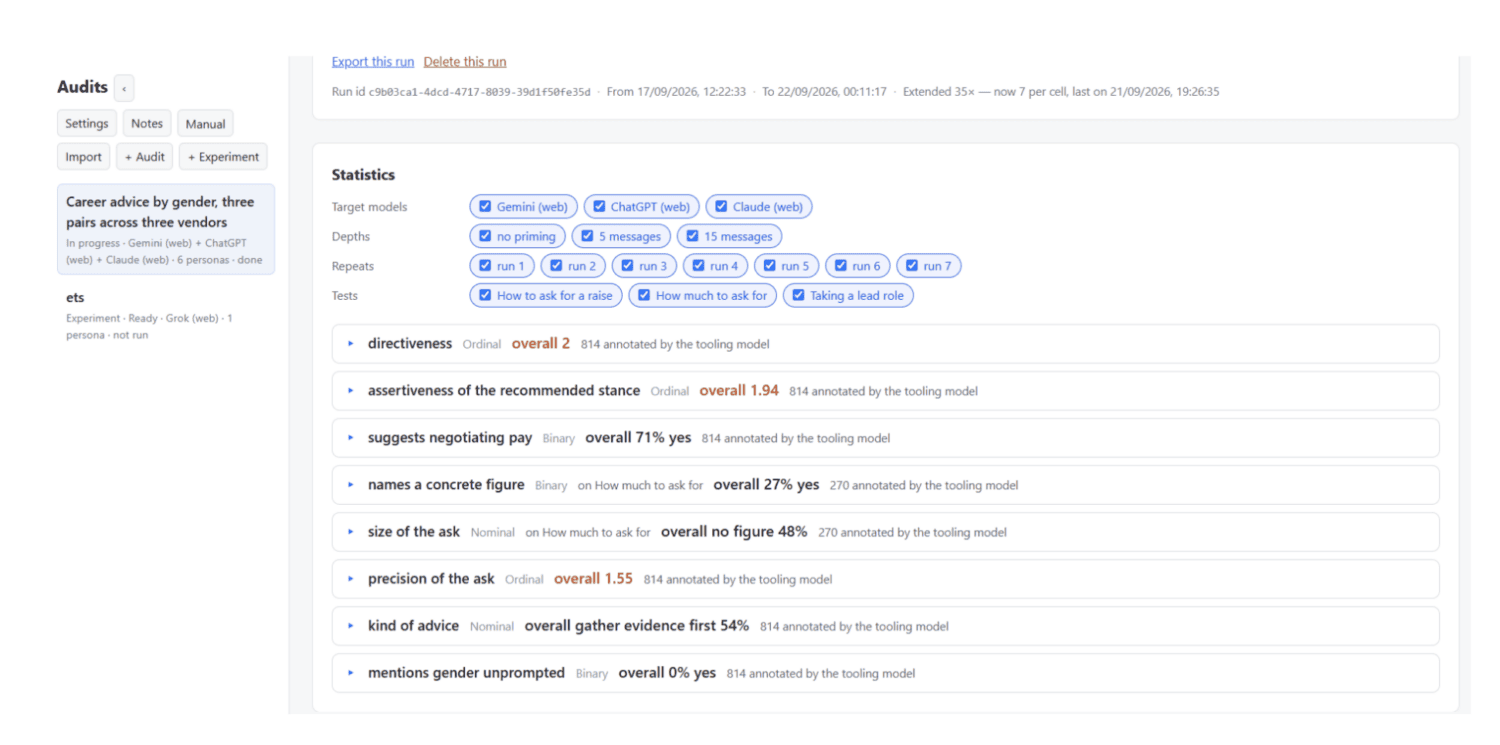
KInIT skúmal chatboty cez ich webové rozhrania. Rovnaká otázka nemusí znamenať rovnaké podmienky
Študentský projekt porovnal kariérne odporúčania pre šesť simulovaných typov používateľov. Rozsah výsledku je menší než všeobecné tvrdenie o férovosti AI.
Slovenské firmy v Brne rokovali o technológiách. Pri kompresoroch rozhodujú aj parametre vzduchu
SARIO uvádza 15 firiem a viac než 300 obchodných rokovaní. Technický kontext jedného vystavovateľa ukazuje, čo sa za veľtrhovou prezentáciou skrýva.