LightOnOCR-3 vyčíta z dokumentu text, polohu odsekov aj údaje z grafu
Tri otvorené modely spájajú prepis a rozpoznanie rozloženia stránky. Vyššie rozlíšenie zvyšuje kvalitu aj výpočtovú záťaž.
Dokument nie je iba rad písmen
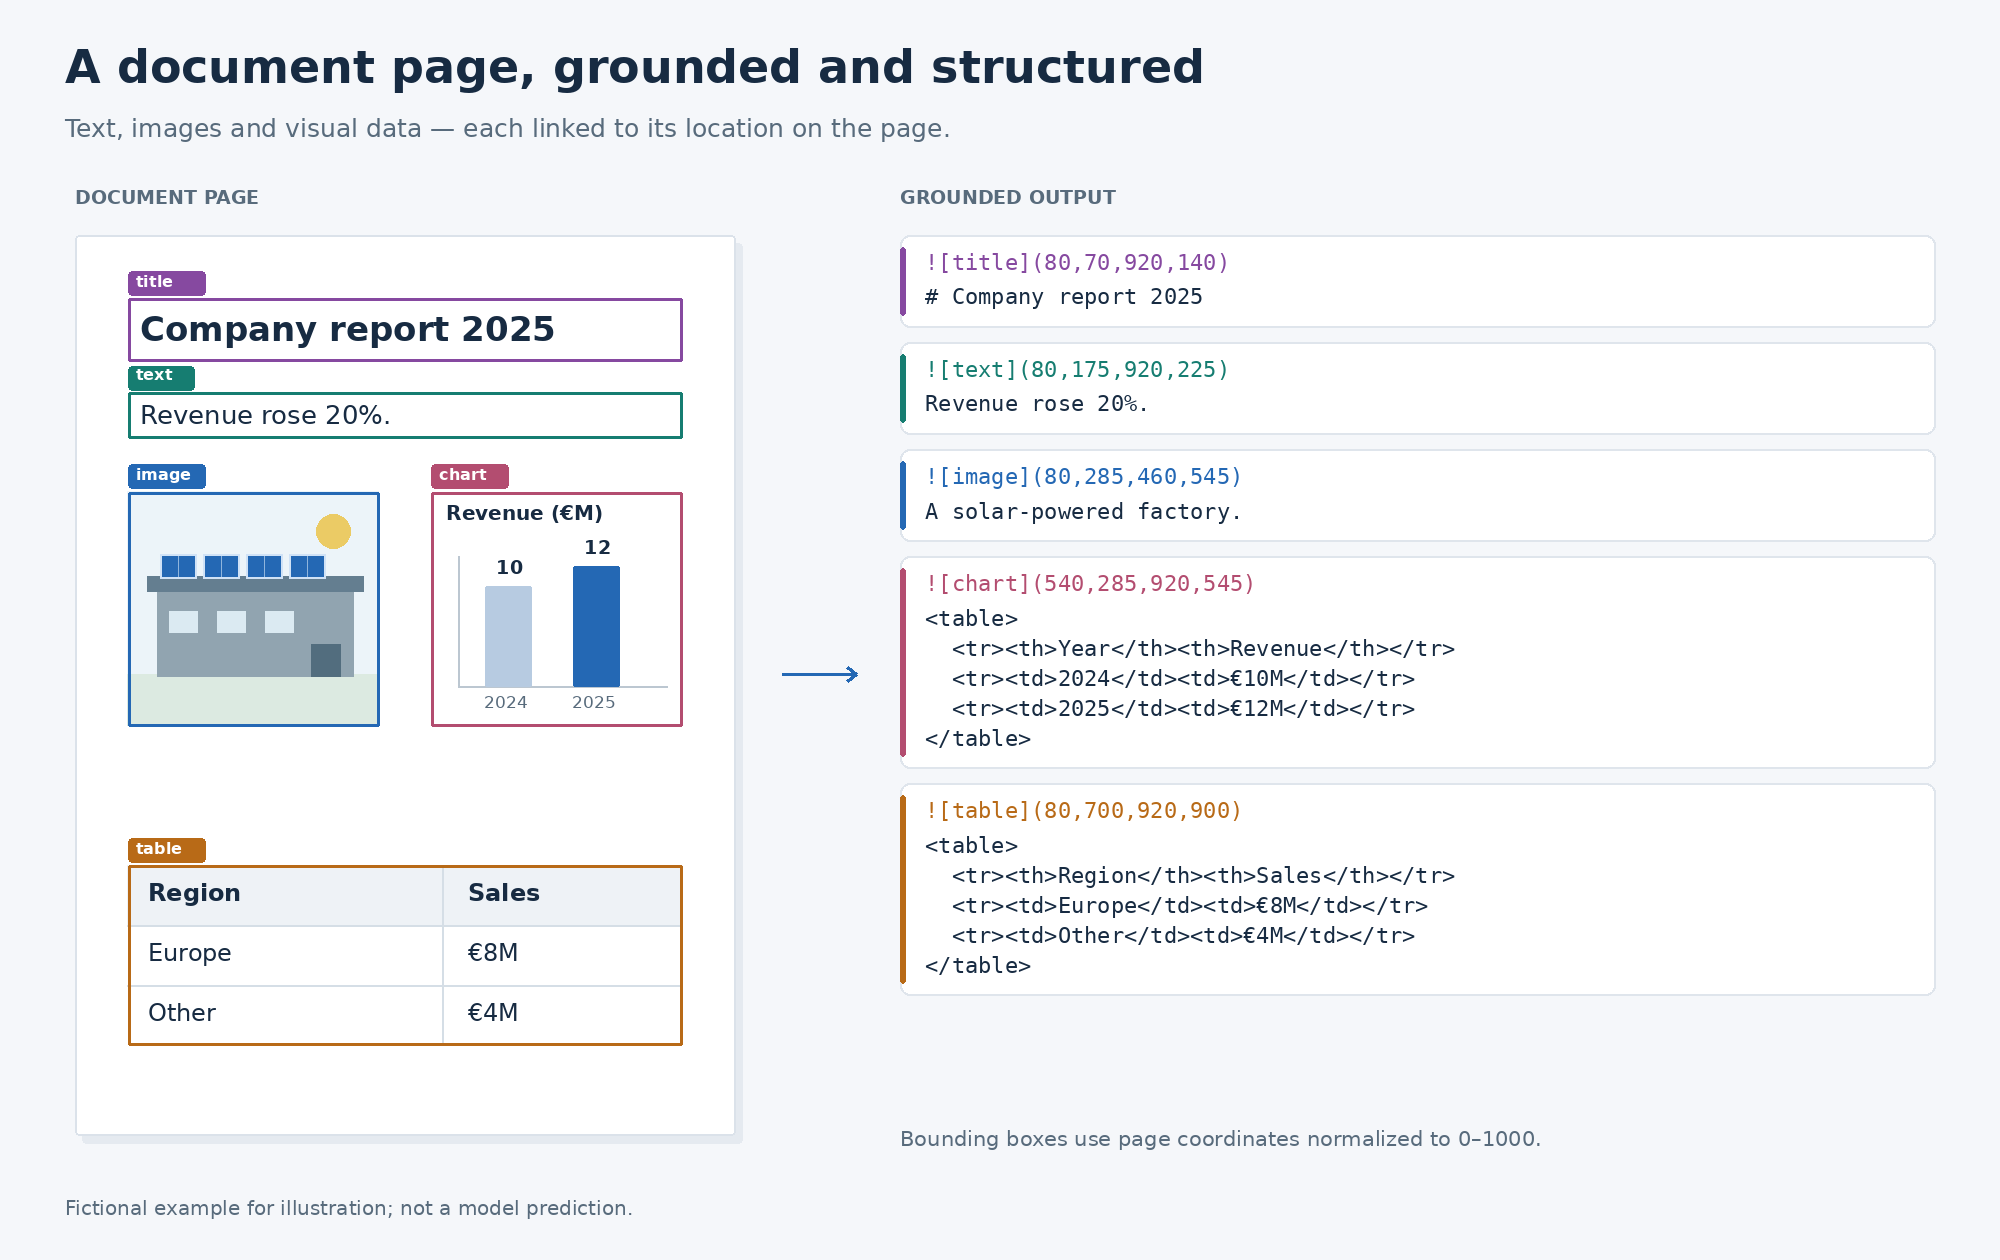
LightOn 8. októbra vydal rodinu LightOnOCR-3 vo variantoch 0.8B, 1B a 4B. Modely sú určené na prevod obrázkov dokumentov na strojovo spracovateľný obsah. Popri prepise vedia označiť jednotlivé oblasti stránky, opísať vložený obrázok a previesť údaje z grafu do tabuľky. Váhy sú dostupné pod licenciou Apache 2.0.
Takéto spojenie má význam pri firemnom archíve. Vyhľadávač potrebuje vedieť, ktoré hodnoty patria do tabuľky, aký nadpis ich uvádza a kde na pôvodnej stránke sa nachádzajú. Samotný text bez tejto väzby môže zameniť poradie stĺpcov alebo priradiť údaj k nesprávnej časti návodu.
Jeden režim prepisuje, druhý pridáva súradnice
Prázdny textový pokyn zachováva bežný prepis. Pokyn grounding doplní ohraničujúce rámčeky s typom oblasti a súradnicami normalizovanými od nuly po tisíc. Obrázky dostanú krátky opis a grafy tabuľku hodnôt. Výstup tak môže súčasne slúžiť čitateľovi aj aplikácii, ktorá potrebuje zvýrazniť nájdený údaj v pôvodnom PDF.
LightOn zverejňuje aj konverzné a vyhodnocovacie nástroje. Tie sú dôležité, pretože výsledky benchmarku ovplyvňuje predspracovanie vstupu aj normalizácia odpovede. Porovnávanie samotných skóre bez rovnakého postupu môže pripisovať modelu rozdiel, ktorý vznikol mimo neho.
Pri tabuľke môže byť rozhodujúca väzba medzi hodnotou, jednotkou a názvom stĺpca. V technickom liste sú napríklad menovitý a maximálny údaj odlišné veličiny, hoci vyzerajú podobne. Zachovanie štruktúry pomáha následnému vyhľadávaniu vrátiť správny riadok a umožňuje používateľovi otvoriť práve tú oblasť stránky, z ktorej odpoveď vychádza.
Rozlíšenie treba prispôsobiť dokumentu
Oficiálna produktová stránka predstavuje model ako základ pre lokálne spracovanie dokumentov. Praktická integrácia však stále zahŕňa vykreslenie stránok, prevod výstupu a následnú kontrolu. Malý text na výkrese potrebuje iné rozlíšenie než jednoduchý formulár; viac obrazových tokenov zároveň znižuje počet stránok spracovaných za sekundu.
Pri overovaní sa oplatí oddeliť tri otázky: či je správny prepis, či sedí priradenie k oblasti a či sú hodnoty z grafu skutočne čitateľné. Najmä posledný prípad potrebuje možnosť odmietnuť neistý výsledok. Pre podnik je preto užitočnejší test na vlastných formulároch a technických prílohách než všeobecné tvrdenie, že nový OCR model rozumie všetkým dokumentom.
Technický kontext
Stav overenia: Spracované podľa zdroja; redakcia postup nereprodukovala.
Verzie: Zdroj neuvádza konkrétne verzie.
Podmienky použitia: Použitie závisí od konkrétnej konfigurácie a dokumentácie uvedenej v zdrojoch.
Obmedzenia: Redakcia nereprodukovala testy dodávateľov; staršie udalosti sú v texte datované.
Zdroje
Súvisiace
Ďalšie články k téme
Timestral predpovedá údaje zo senzorov a zohľadní aj plán výroby
Mistral vydal štyri modely časových radov. Ich prínosom je spoločné spracovanie súvisiacich veličín a vyjadrenie neistoty predpovede.
Muse Spark Open: otvorené váhy veľkého multimodálneho modelu potrebujú veľkú infraštruktúru
Hugging Face rozoberá architektúru modelu Meta aj podporované spúšťanie. Miliónový kontext má výraznú pamäťovú cenu.
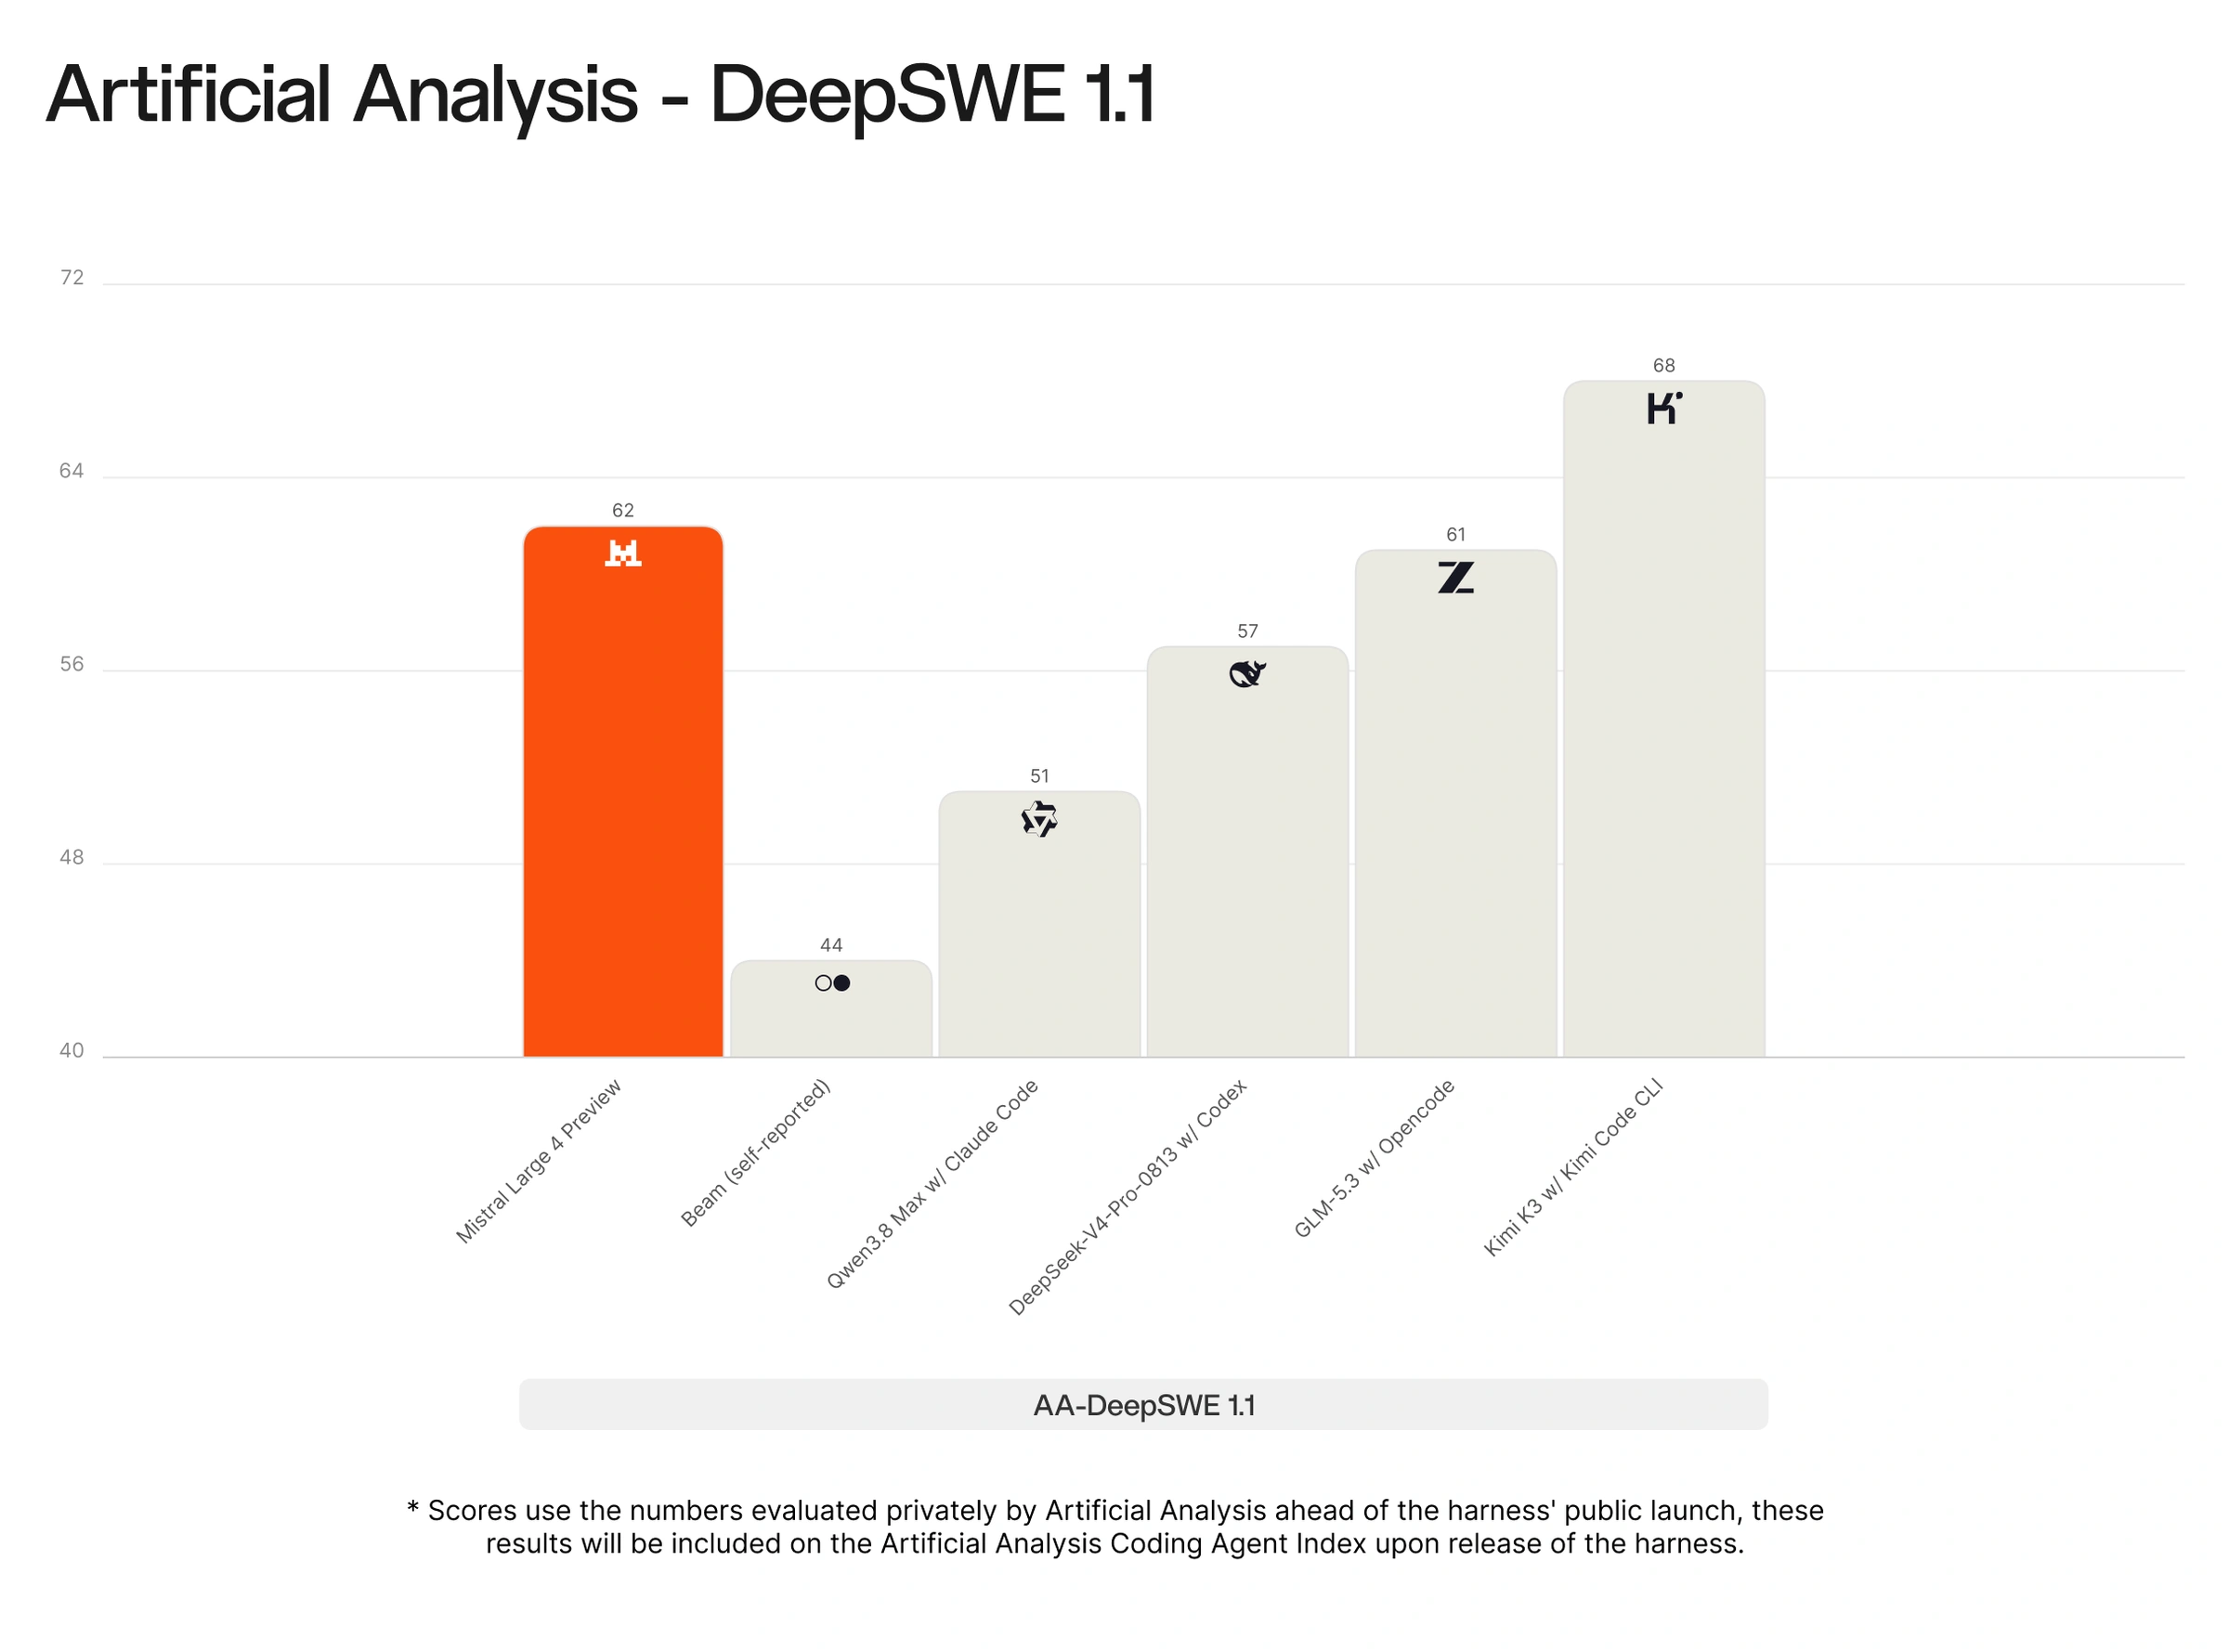
Mistral Large 4 má bilión parametrov. Otvorené váhy sú zatiaľ prísľubom
Verejná ukážka nového modelu oddeľuje dnešný prístup cez službu od plánovaného samostatného prevádzkovania.
Liquid AI prináša lokálneho agenta s dvoma miliardami aktívnych parametrov
LFM2.5-24B-A2B rozširuje kontext a podporuje nástroje. Malý aktívny výpočet však neznamená malú veľkosť celého modelu.