EmbeddingGemma 2 prepája text, obraz a zvuk do jedného vyhľadávania
Menší otvorený model od Googlu vytvára spoločný priestor pre rôzne médiá. Pre lokálny archív je podstatná aj veľkosť vektorového indexu.
Vyhľadávanie podľa významu
Google 6. októbra predstavil EmbeddingGemma 2 pod licenciou Apache 2.0. Model premieňa text, obraz, zvuk a video na číselné reprezentácie, ktoré sa dajú porovnávať podľa podobnosti. Používateľ tak môže textovým opisom hľadať relevantný úsek nahrávky alebo obrazový materiál. Model sám osebe nepíše odpoveď ako chatbot.
Jeho úloha je užšia, ale praktická: nájsť podklad, ktorý potom otvorí človek alebo použije ďalší model. Kvalita takéhoto vyhľadávania závisí aj od rozdelenia dokumentov, metadát a spôsobu, akým aplikácia spracuje výsledky.
Jednotlivé vstupy majú vlastné nároky
Celý model má 740 miliónov parametrov. Textová časť potrebuje 270 miliónov, obrazový enkóder pridáva 170 a zvukový 300 miliónov. Aplikácia zameraná iba na dokumenty tak nemusí používať celý multimodálny variant. Kontextové okno má 8-tisíc tokenov; Google uvádza kapacity až 5,5 minúty audia, 29 obrázkov alebo 58 video snímok.
Výstupný vektor možno skrátiť zo 768 rozmerov na 512, 256 alebo 128. Posledná možnosť znamená šesťkrát menej hodnôt vo vektore. Neznamená však automaticky šesťkrát menšiu celú aplikáciu: index obsahuje aj ďalšie dáta a kratšie reprezentácie treba preveriť na kvalite vyhľadávania.
Lokálne spracovanie treba merať na zariadení
Google pri kvantizovanom modeli na Pixel 11 Pro uvádza približne 191 MB aktívnej RAM pre textové váhy a 567 MB pre celý multimodálny model. Tieto údaje opisujú konkrétne meranie, nie univerzálnu spotrebu aplikácie na každom telefóne. Do rozpočtu vstupuje aj index, načítané médiá a runtime.
Pre firemný archív môže byť zaujímavé, že reprezentácie vznikajú priamo na zariadení. Ochrana dát však závisí od celej aplikácie, vrátane synchronizácie a logov. Pilot má overiť, či slovenská otázka nájde správnu stranu manuálu alebo časť nahrávky, a porovnať krátke vektory s plnou veľkosťou. Tak sa ukáže, kde úspora ešte zachováva užitočný výsledok.
Výsledok vyhľadávania sa dá posúdiť na malej označenej sade otázok. Pri každej má tím vedieť, ktorý dokument alebo úsek je správny. Následne porovná, či sa nachádza medzi prvými výsledkami a ako často vyhľadávač ponúkne podobne znejúci, ale nesprávny materiál. Taký test je zvlášť dôležitý pri kombinácii technickej slovenčiny, anglických názvov súčiastok a nahrávok s hlukom či neúplným prepisom.
Technický kontext
Stav overenia: Spracované podľa zdroja; redakcia postup nereprodukovala.
Verzie: Zdroj neuvádza konkrétne verzie.
Podmienky použitia: Použitie závisí od konkrétnej konfigurácie a dokumentácie uvedenej v zdrojoch.
Obmedzenia: Redakcia nereprodukovala testy dodávateľov; staršie udalosti sú v texte datované.
Zdroje
Súvisiace
Ďalšie články k téme
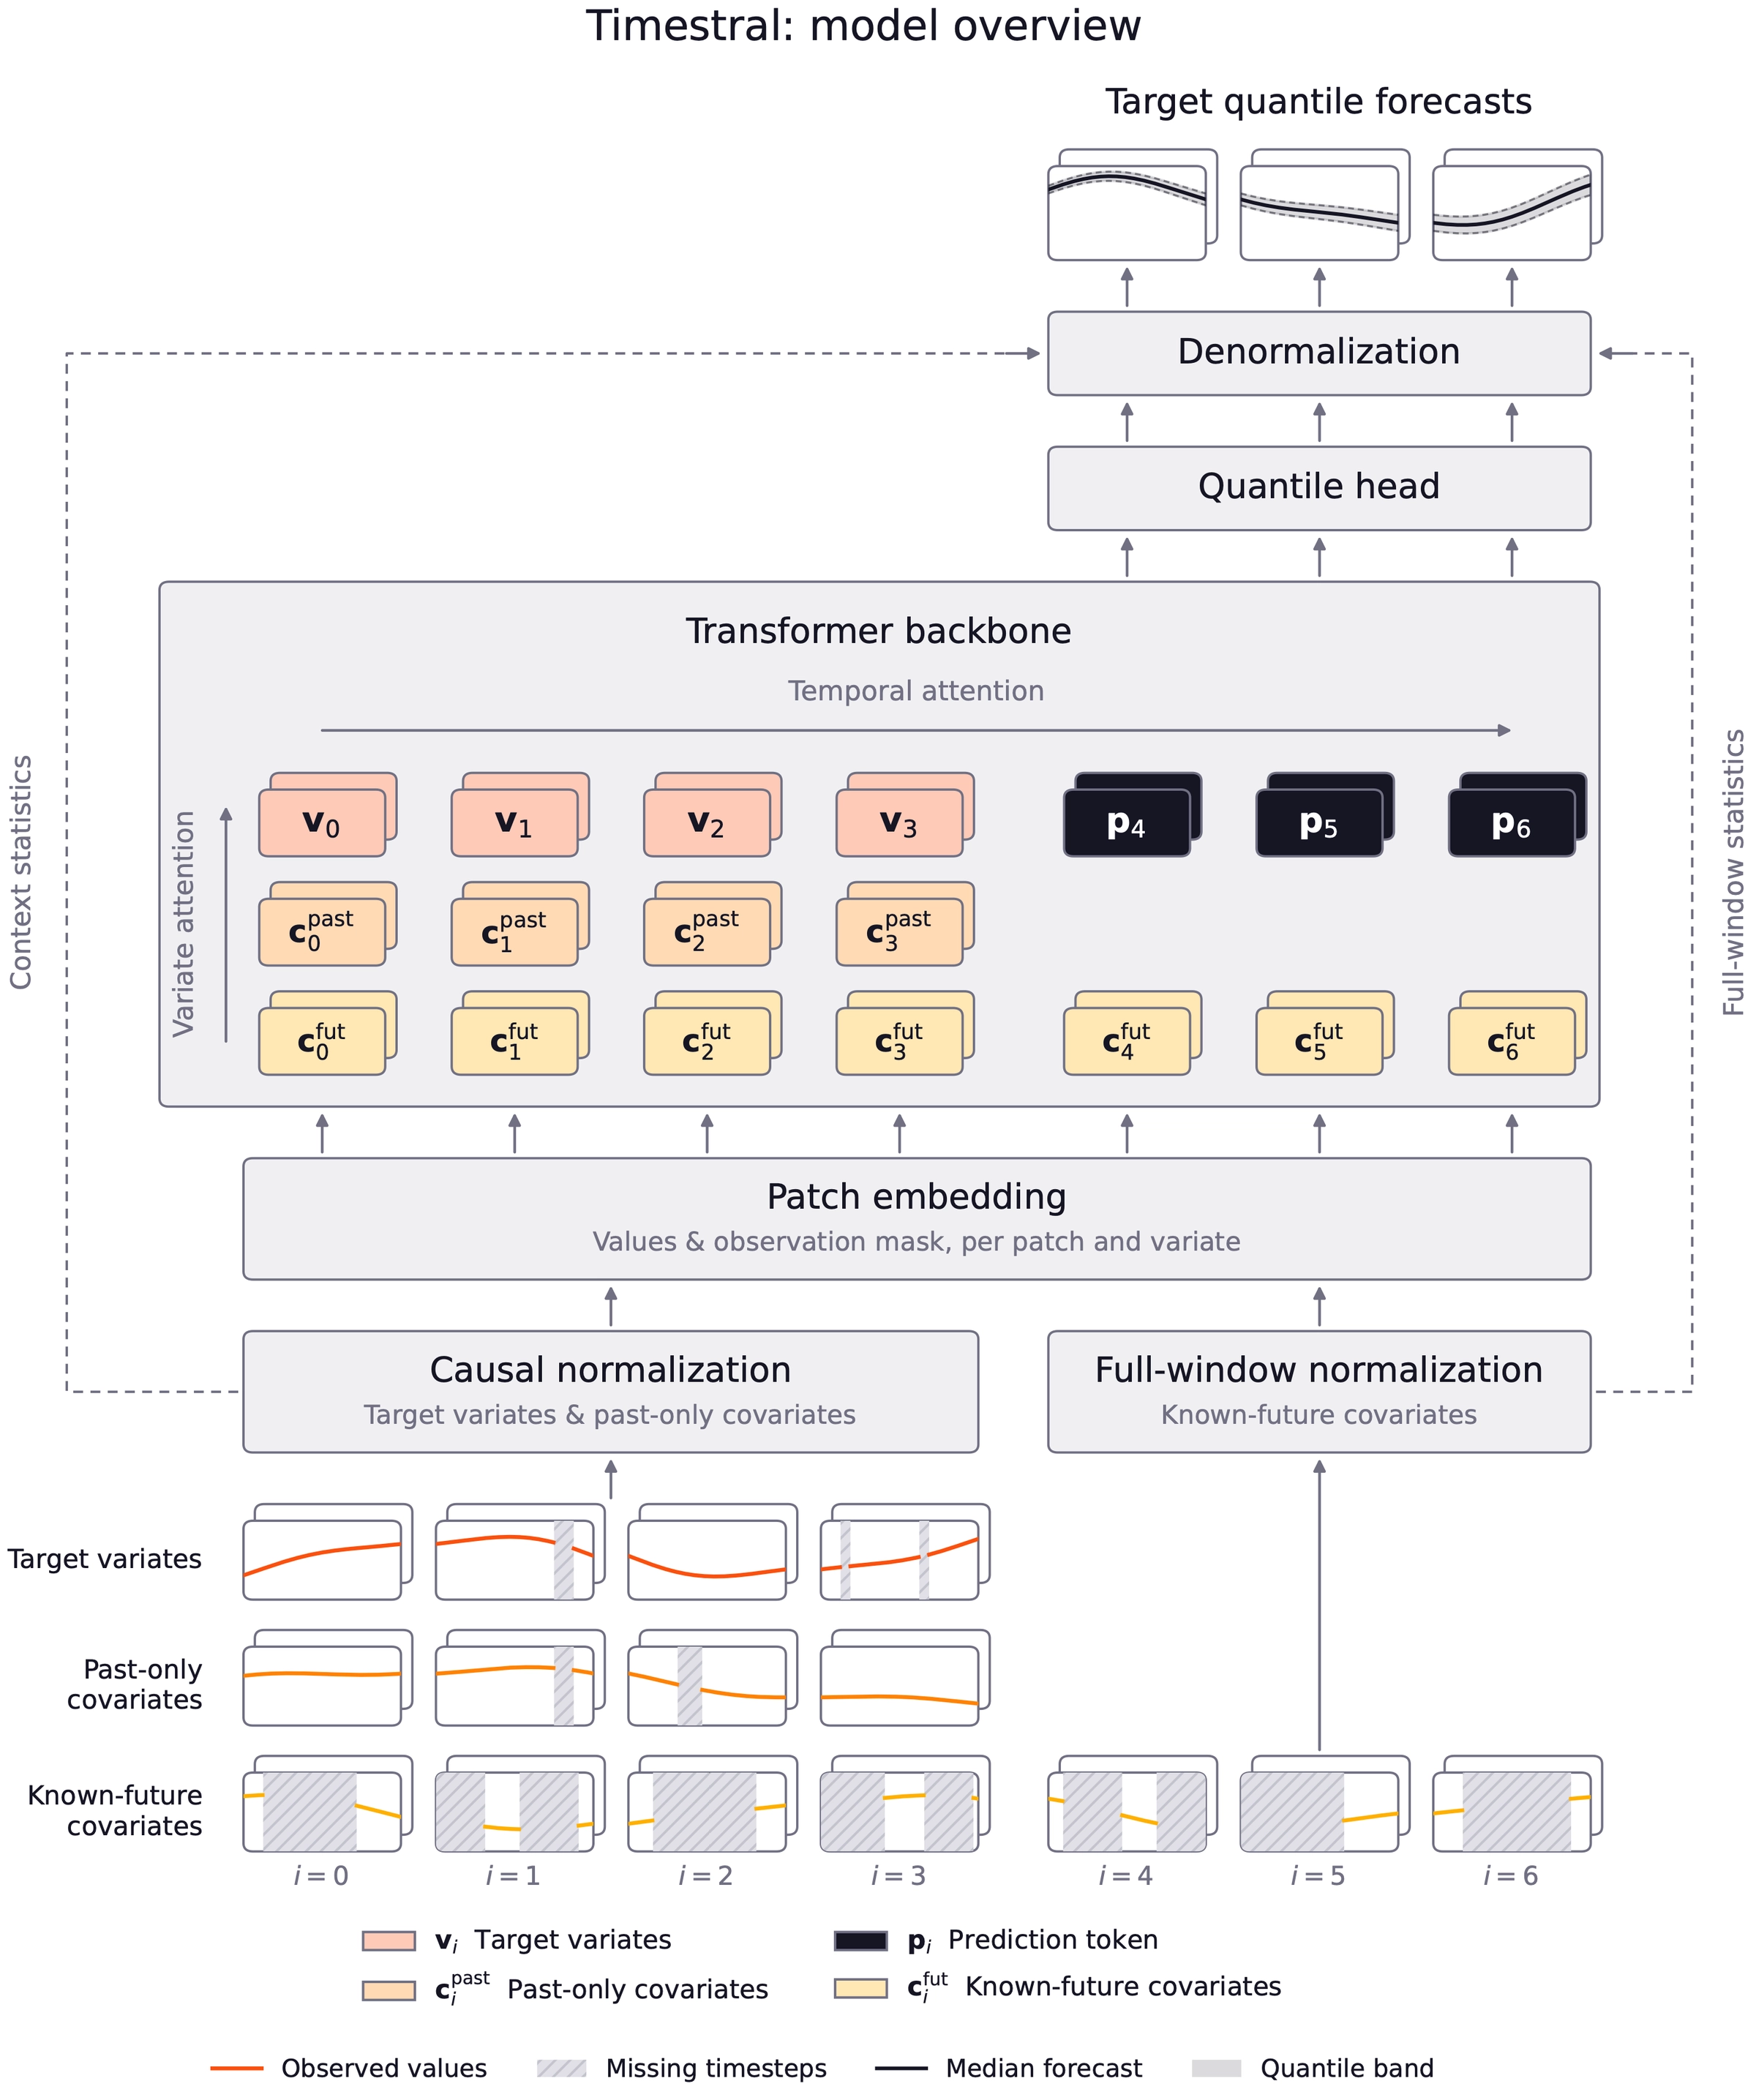
Timestral predpovedá údaje zo senzorov a zohľadní aj plán výroby
Mistral vydal štyri modely časových radov. Ich prínosom je spoločné spracovanie súvisiacich veličín a vyjadrenie neistoty predpovede.
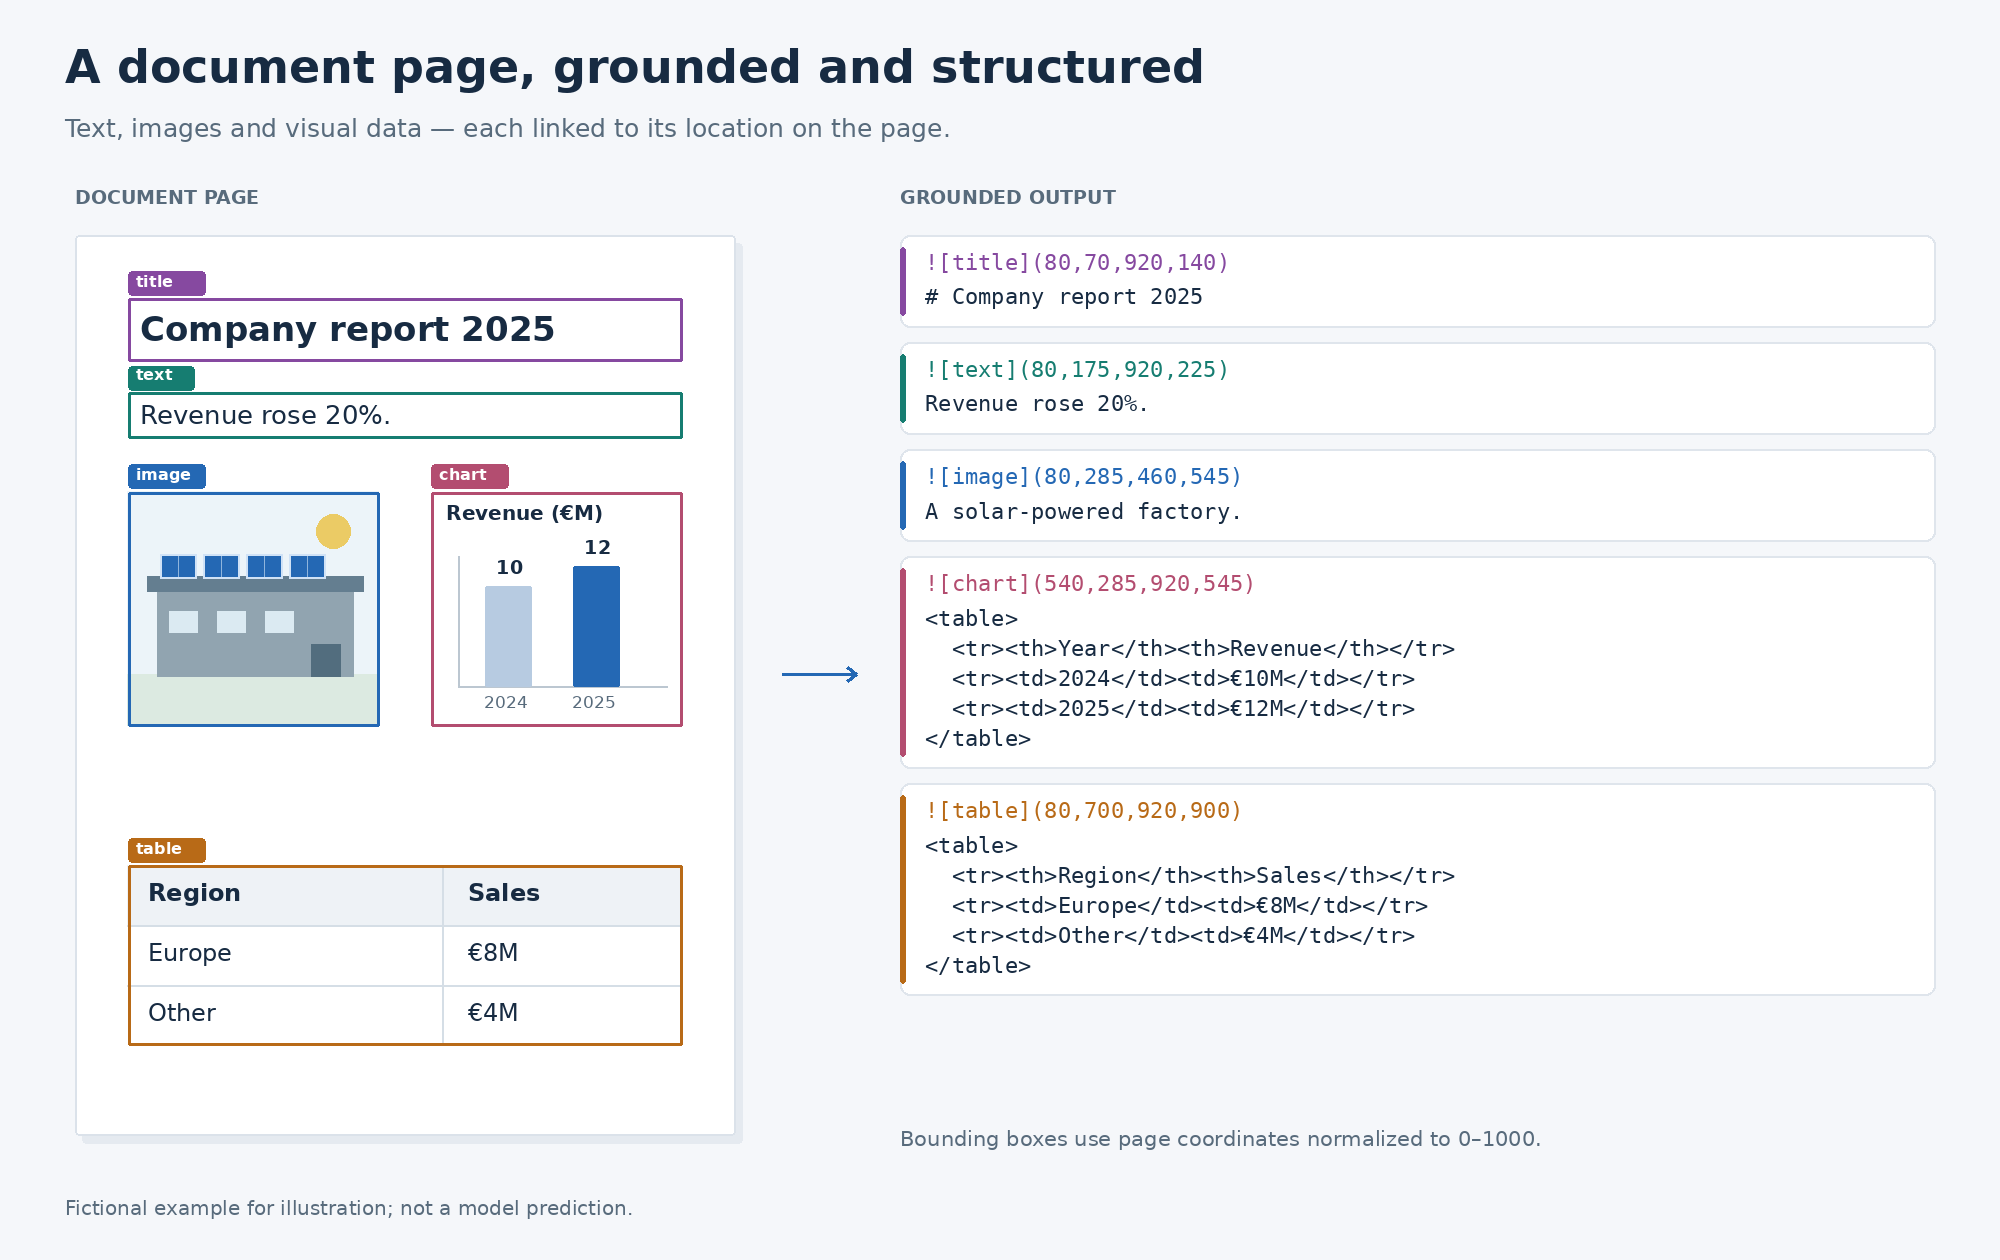
LightOnOCR-3 vyčíta z dokumentu text, polohu odsekov aj údaje z grafu
Tri otvorené modely spájajú prepis a rozpoznanie rozloženia stránky. Vyššie rozlíšenie zvyšuje kvalitu aj výpočtovú záťaž.
Muse Spark Open: otvorené váhy veľkého multimodálneho modelu potrebujú veľkú infraštruktúru
Hugging Face rozoberá architektúru modelu Meta aj podporované spúšťanie. Miliónový kontext má výraznú pamäťovú cenu.
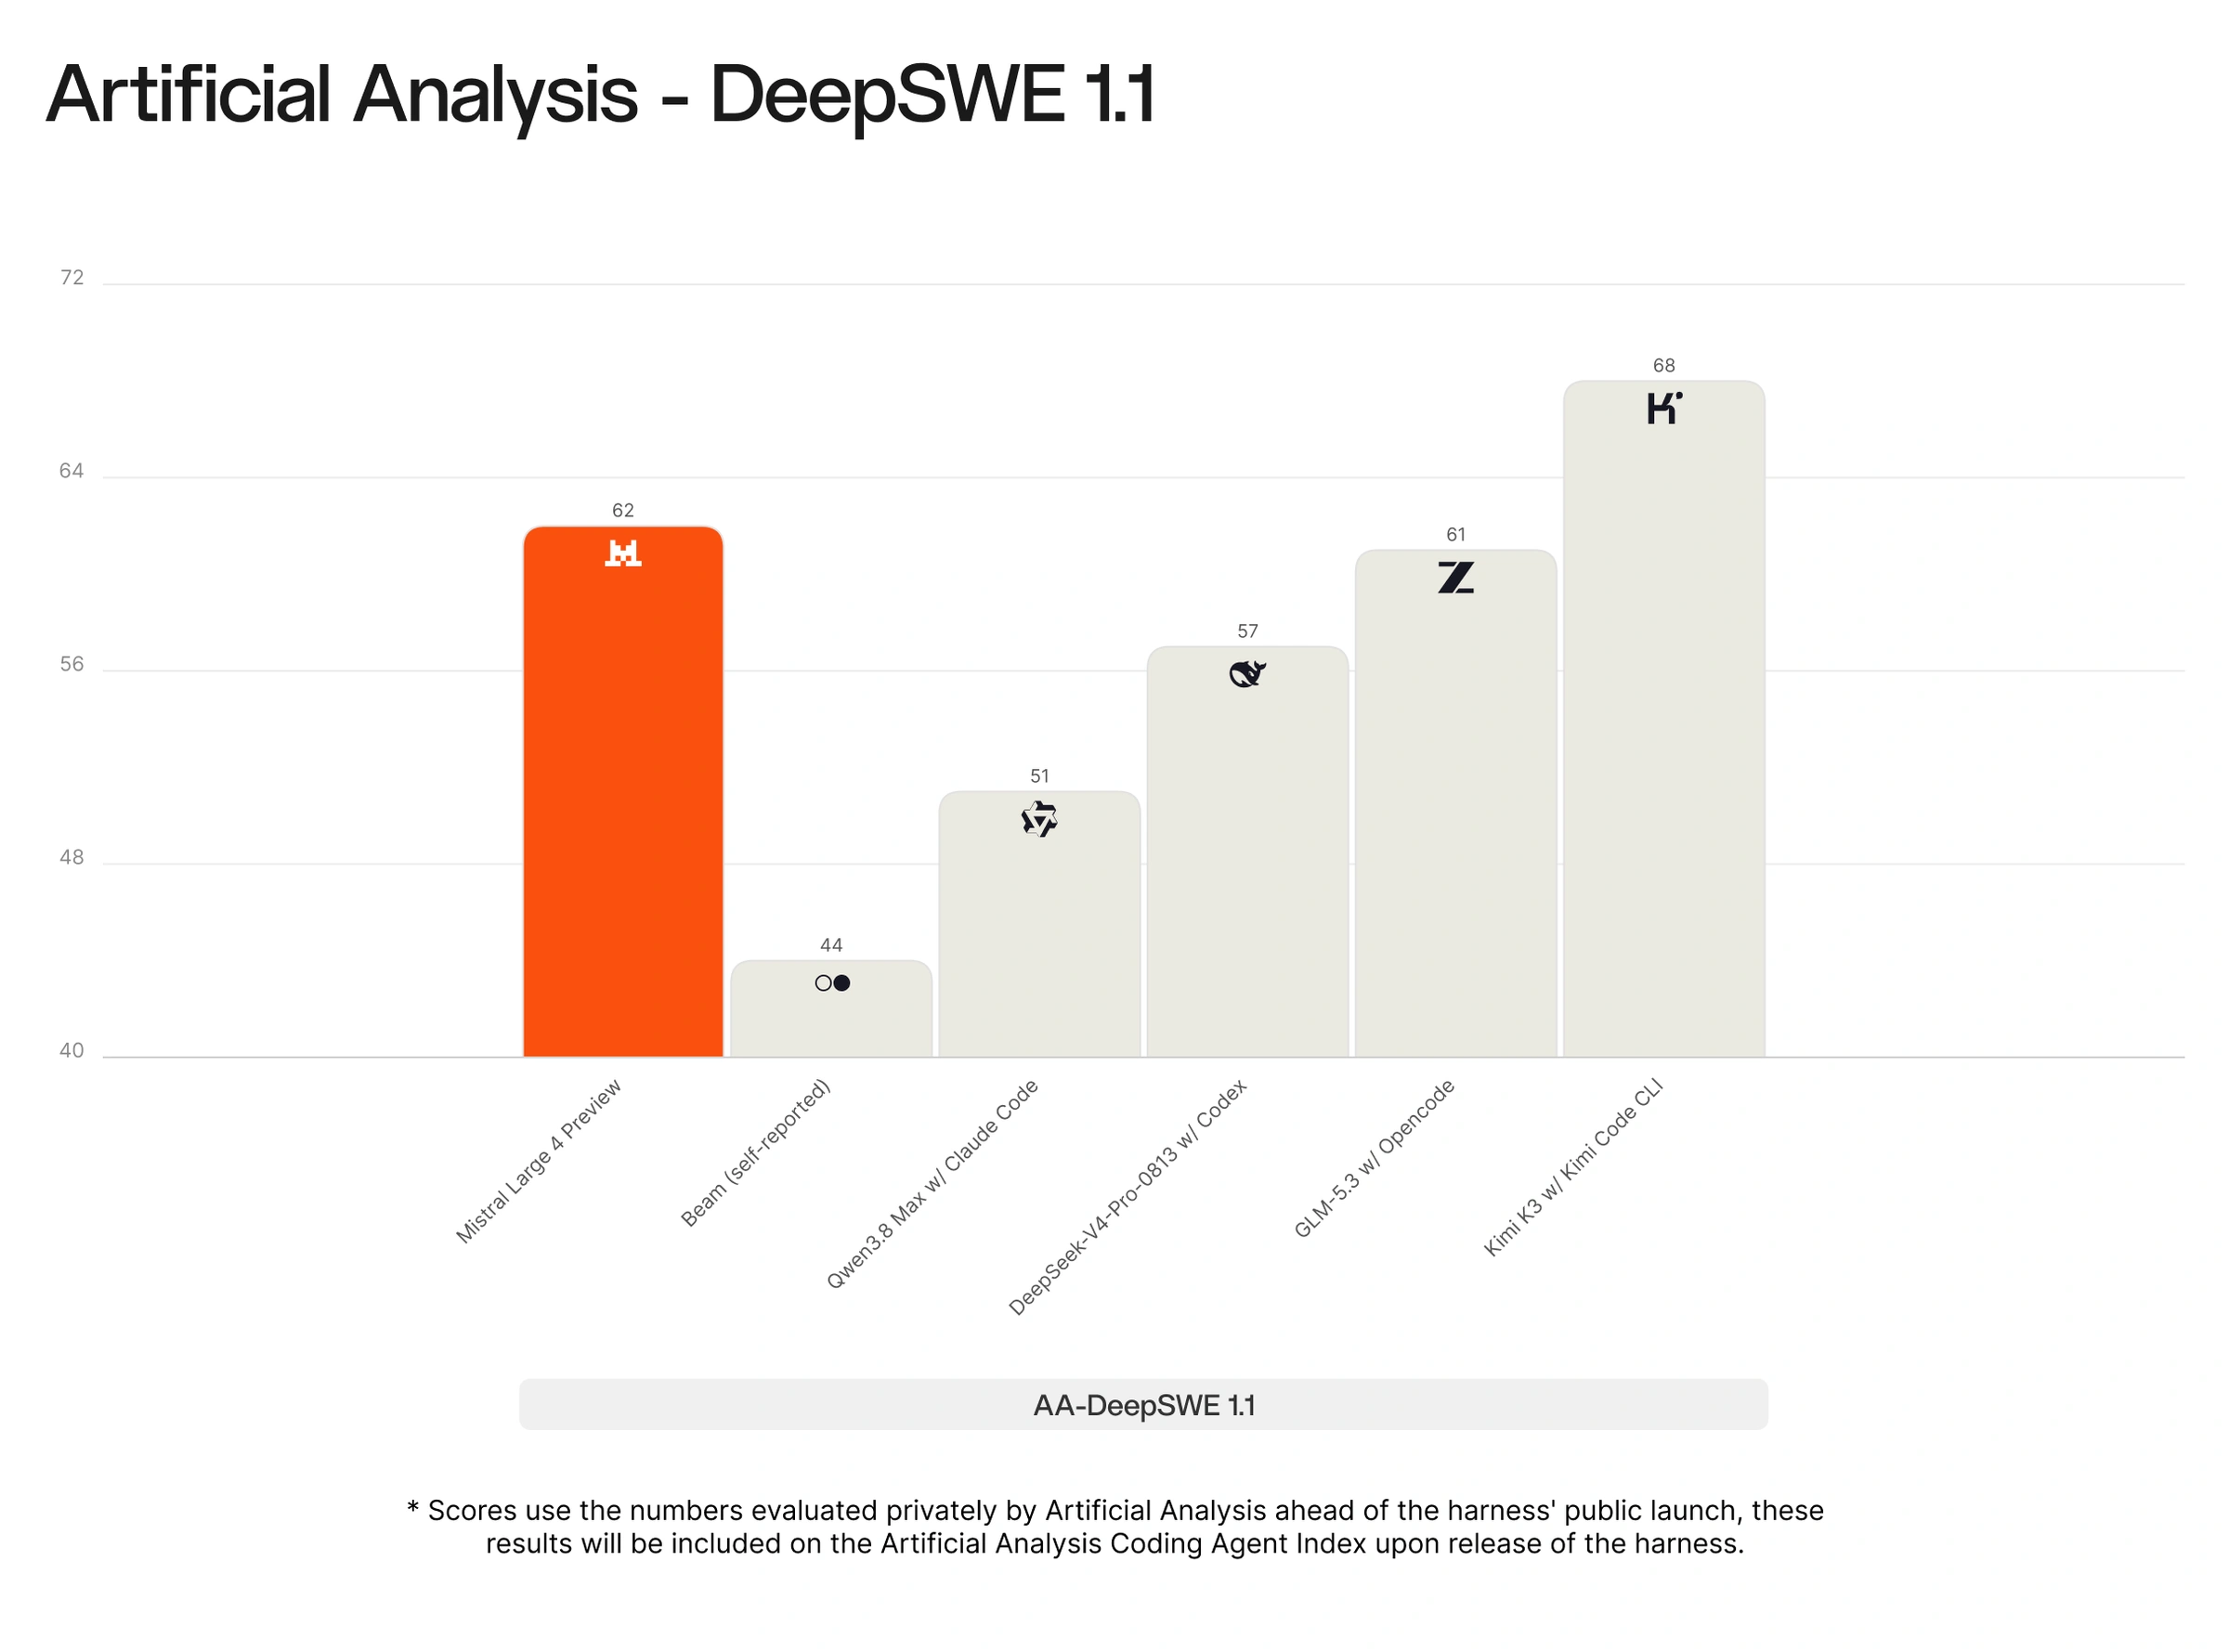
Mistral Large 4 má bilión parametrov. Otvorené váhy sú zatiaľ prísľubom
Verejná ukážka nového modelu oddeľuje dnešný prístup cez službu od plánovaného samostatného prevádzkovania.