Google Research opísal ToolGrad: answer-first generovanie datasetov pre tool-use v práci predstavenej na ACL 2026
Google Research 10. septembra 2026 zverejnil popis frameworku ToolGrad, ktorý pri tvorbe syntetických datasetov pre používanie nástrojov obracia bežný postup: najprv vytvorí a overí reťazec API volaní, až potom k nemu doplní používateľský dopyt. Zdroj uvádza nižšie náklady a vyššiu úspešnosť generovania, no ide o vlastné výskumné tvrdenia bez nezávislého overenia v dodanom podklade.
Čo Google mení
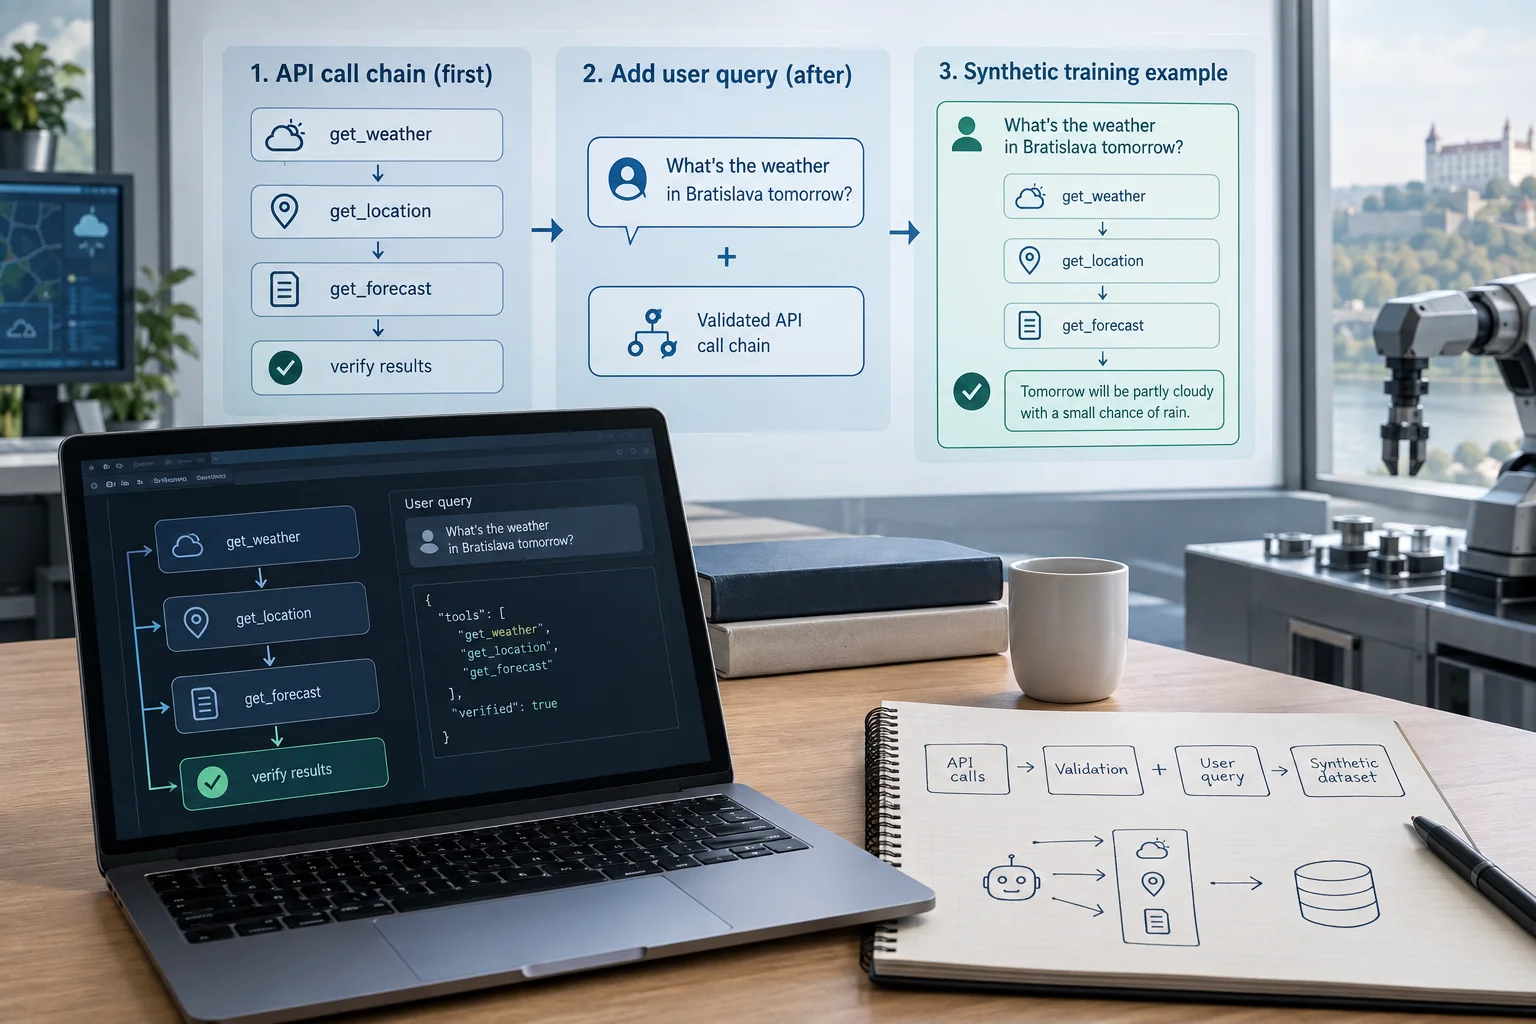
Google Research zverejnil 10. septembra 2026 popis frameworku ToolGrad, ktorý mení spôsob tvorby tréningových dát pre modely používajúce nástroje a API. Namiesto bežného postupu „najprv používateľský dopyt, potom hľadanie riešenia“ volí answer-first prístup: najprv vytvorí overený reťazec API volaní a až následne k nemu doplní zodpovedajúci používateľský prompt. Podľa zdroja bola práca predstavená na ACL 2026. 1
Pre vývojárov agentov je to podstatná zmena najmä preto, že problém presúva z nákladného hľadania funkčnej trajektórie k postupnému skladaniu užitočných krokov. V blogu Google sa výslovne uvádza, že pri staršom „query-first“ postupe sa typicky najprv vygeneruje hypotetická inštrukcia a potom agent cez DFS hľadá riešenie, čo autori označujú za inherentne neefektívne. 1
Ako ToolGrad funguje
Text opisuje štyri jadrové moduly frameworku. API Proposer v každej iterácii zúži vzorku API na niekoľko sľubných kandidátov. API Executors ich skúšajú paralelne a pripravujú reporty z vykonania. API Selector z týchto reportov vyberie najlepší ďalší krok a tým poskytuje smerovú spätnú väzbu, ktorú autori prirovnávajú k textovým „gradientom“. Nakoniec LLM Updater upraví syntetický používateľský dopyt aj odpoveď tak, aby zodpovedali rozšírenému workflowu. Opakovaním vznikne dátová vzorka pozostávajúca z používateľského dopytu, overeného API workflowu a finálnej odpovede AI. 1
ToolGrad pritom nadväzuje na myšlienku textual gradients z TextGrad, kde LLM kritik neposiela číselný gradient, ale slovný opis toho, čo zlepšiť. V ToolGrad sa tento princíp nepoužíva na ladenie promptu, ale na iteratívne budovanie validných API workflowov z rozsiahlych knižníc nástrojov. 1
Aký praktický význam tvrdí zdroj
Google v texte uvádza, že pri experimentoch použil databázu ToolBench s viac ako 16-tisíc reálnymi API a porovnal query-first prístup založený na DFS s vlastným answer-first prístupom. Zdroj tvrdí, že ToolGrad vie generovať zložitejšie, dlhšie tool-use dáta pri nižších nákladoch a vyššej úspešnosti generovania. V sprievodnom texte sa objavuje aj údaj o 99,8 % pass rate v porovnaní s predchádzajúcim prístupom. 1
Ďalšia časť blogu opisuje malé datasety ToolGrad-500, na ktorých autori doladili modely Gemma-3 1B, 4B a 12B. Vyhodnotenie prebehlo na benchmarku Berkeley Function Calling Leaderboard (BFCL), ktorý podľa zdroja používa inú sadu nástrojov než ToolBench. Google tvrdí, že takto doladené modely zlepšili tool-use výkon oproti bázovým verziám a že variant ToolGrad-12B dosiahol skóre 83,1, teda hodnotu blízku vybraným proprietárnym modelom uvedeným v texte. 1
Hranice toho, čo vieme
Prakticky užitočný je najmä samotný návrh pipeline: najprv overený workflow, potom prompt. To je konkrétna architektonická idea, ktorú možno sledovať pri návrhu syntetických dát pre agentov. Naopak, tvrdenia o nižšej cene, takmer stopercentnej úspešnosti či konkurencieschopnosti voči špičkovým modelom treba čítať opatrne: v dodanom podklade ide o vlastné tvrdenia Google Research z firemného výskumného blogu, nie o nezávisle reprodukované overenie. Zdroj tiež neobsahuje úplnú metodiku experimentov ani dôkaz o všeobecnej produktovej dostupnosti ToolGrad ako komerčného nástroja. 1
Technický kontext
Stav overenia: Spracované podľa zdroja; redakcia postup nereprodukovala.
Verzie: Zdroj neuvádza konkrétne verzie.
Dátum pôvodného zdroja: 10. septembra 2026
Podmienky použitia: Základná orientácia v tool-calling agentoch, API workflowoch, syntetickom generovaní tréningových dát a post-trainingu LLM modelov.
Obmedzenia: Podklad tvorí jediný primárny zdroj z firemného výskumného blogu Google Research. Výkonnostné tvrdenia, benchmarkové skóre, náklady generovania aj pass rate sú tvrdenia autora zdroja bez nezávislého overenia v dodanom balíku. Podklad neobsahuje úplný paper ani reprodukčný protokol, preto nemožno potvrdiť metodiku, presné podmienky testov ani dostupnosť implementácie ako produktu.
Zdroje
Súvisiace
Ďalšie články k téme
Google Research predstavilo MilleMiglia pre middle-mile logistiku ako open-source generátor benchmarkov
Google Research 18. septembra 2026 predstavilo MilleMiglia, open-source generátor realistických inštancií pre middle-mile logistiku. Podľa autorov má vyplniť nedostatok verejných dát pre výskum optimalizácie sietí medzi distribučnými centrami; zdroj však neobsahuje nezávislé testy kvality ani porovnanie výkonu solverov.
Fraunhofer v projekte WESPE predstavil webovú platformu a AR prototyp pre montáž tepelných čerpadiel v Nemecku
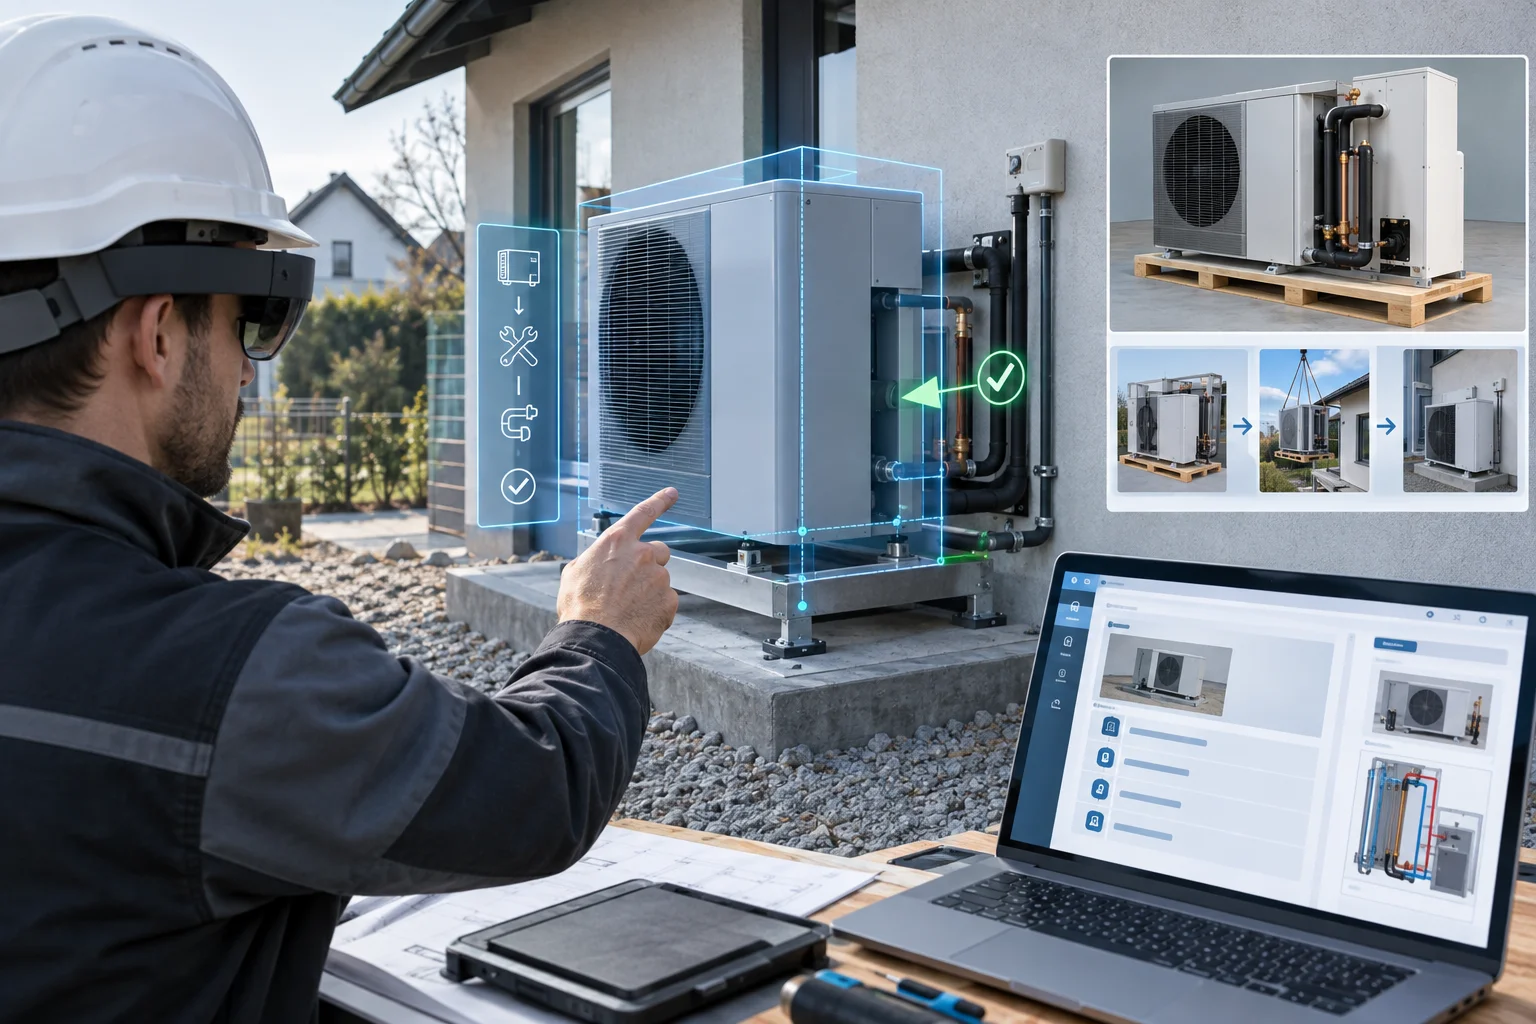
Fraunhofer zverejnil výsledky projektu WESPE zameraného na rýchlejšiu montáž tepelných čerpadiel pri rekonštrukciách budov. Podľa tlačovej správy vznikla webová platforma pre pracovné postupy a prototyp AR aplikácie Heat Pump PlanAR, pričom zdroj opisuje aj testy prefabrikovaných a predmontovaných riešení v realistických podmienkach.
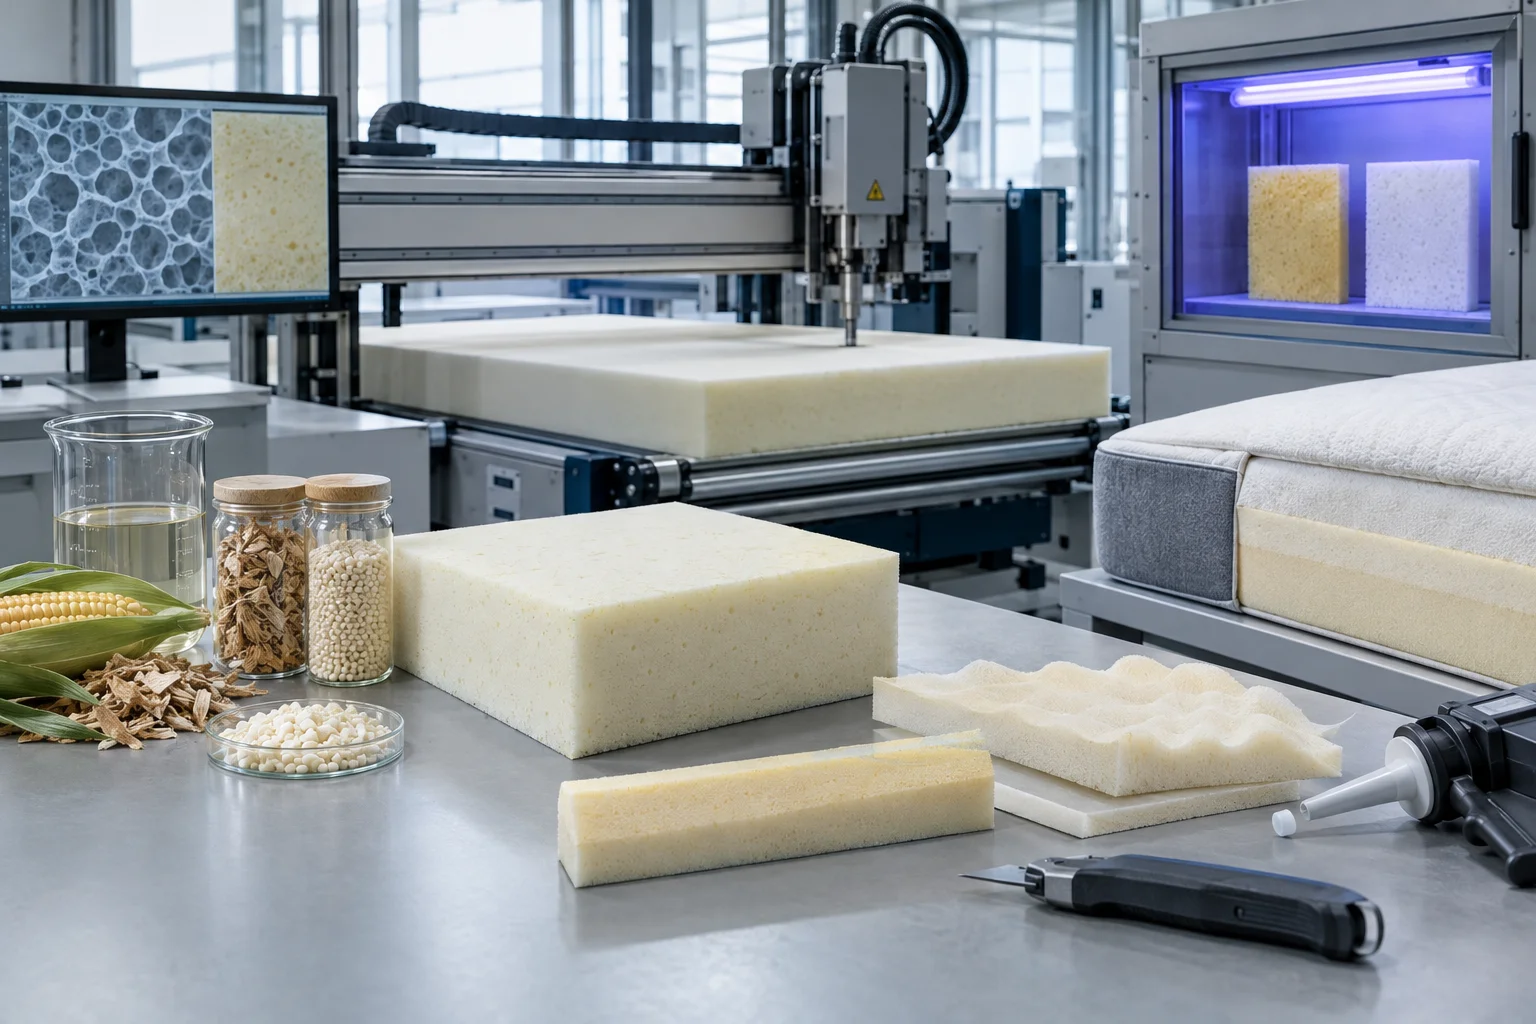
Fraunhofer LBF v Nemecku predstavil bio‑based PU penu OrganoFoam pre čalúnenie a matrace
Fraunhofer LBF oznámil výsledok projektu OrganoFoam: laboratórne vyrábanú polyuretánovú penu z viac než 90 % bio-založených surovín pre čalúnenie a matrace. Podľa tlačovej správy sa dala rezať a lepiť na existujúcich strojoch partnera Friedrich Platt GmbH a v UV teste žltla pomalšie než bežná referenčná pena. Ide však o výskumný výsledok a demonštrátor, nie o komerčne dostupný produkt.
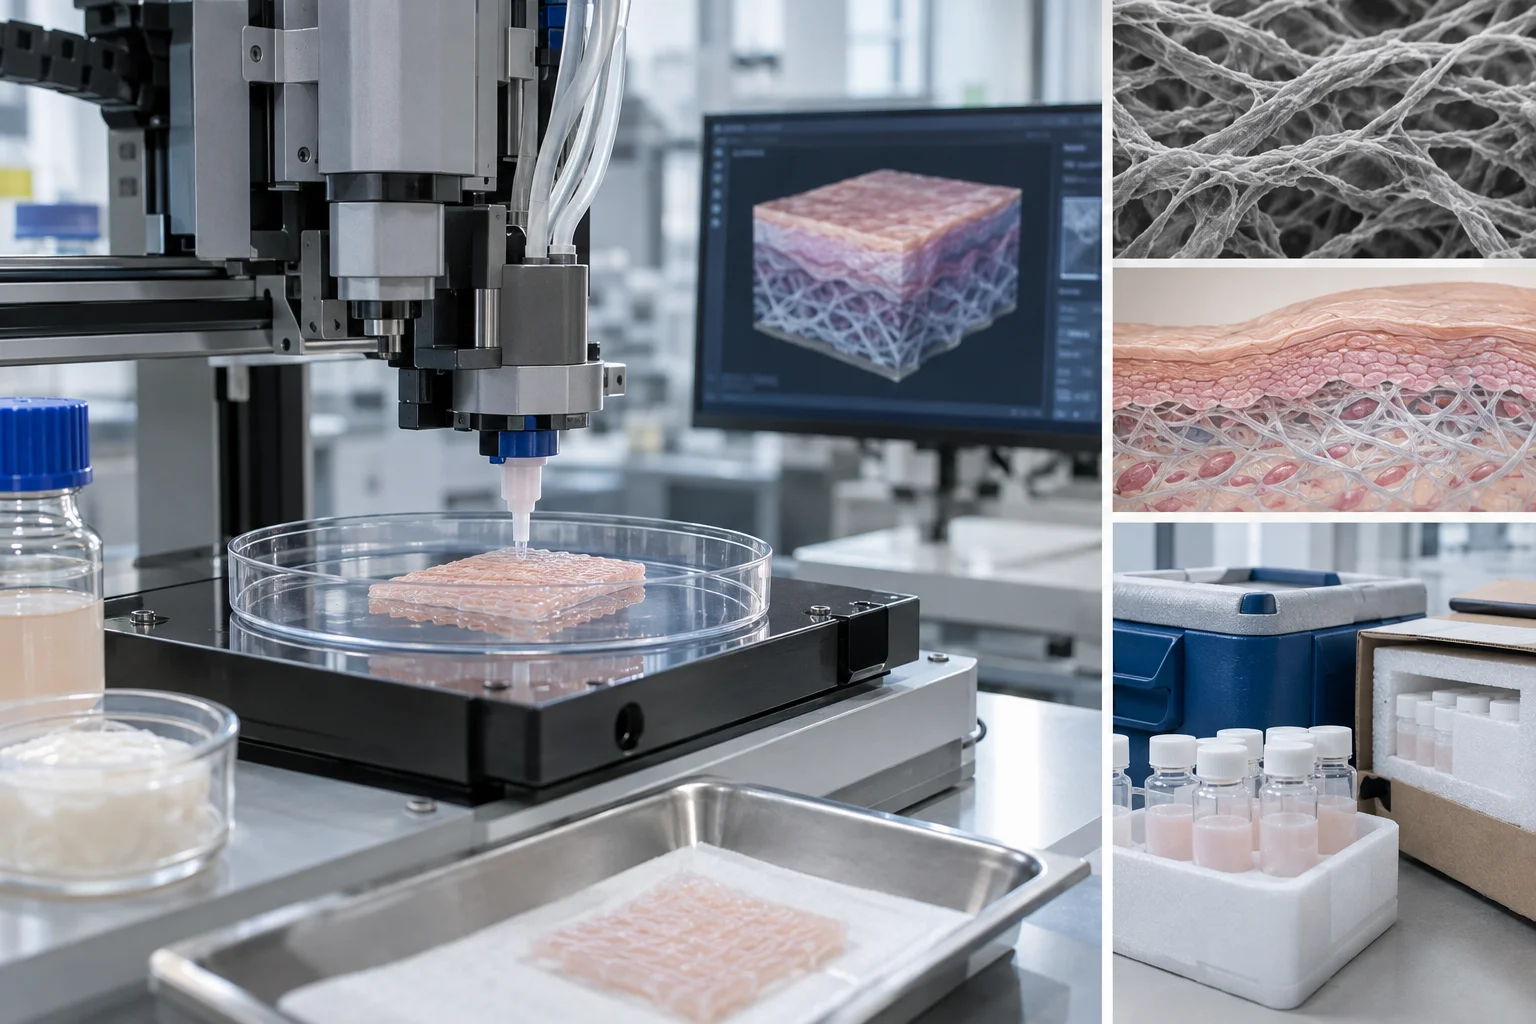
Fraunhofer v projekte PhysioINK ukázal prvé vytlačené kožné tkanivo z kolagénového bioatramentu v Nemecku
Fraunhofer vo výskumnom projekte PhysioINK oznámil prvé vytlačené kožné tkanivo s fyziologickou kolagénovou fibrilárnou štruktúrou. Tlačová správa zároveň opisuje mechanizmus stabilizácie proteínových bioatramentov, interné testy skladovania a dopravy v Nemecku aj hranice výsledkov: ide o priebežný výskum bez klinickej validácie a bez doloženej komerčnej dostupnosti.